2026 年 9—10 月,BioTender 本次清单收录了 19 个围绕全原子建模与设计的项目。它们覆盖结构生成、复合物预测、结构编码和设计优化等环节,共同把蛋白设计推向更细的原子尺度。
共同变化,是设计要求越来越具体。能否保住一个催化基团的位置、容纳一种化学修饰,甚至让抗体改变受体信号?原子级建模正在把这些要求变成可以计算和检验的对象。这轮竞赛的焦点,正在从生成结构延伸到控制功能。
骨架搭好了,原子就会各就各位吗?
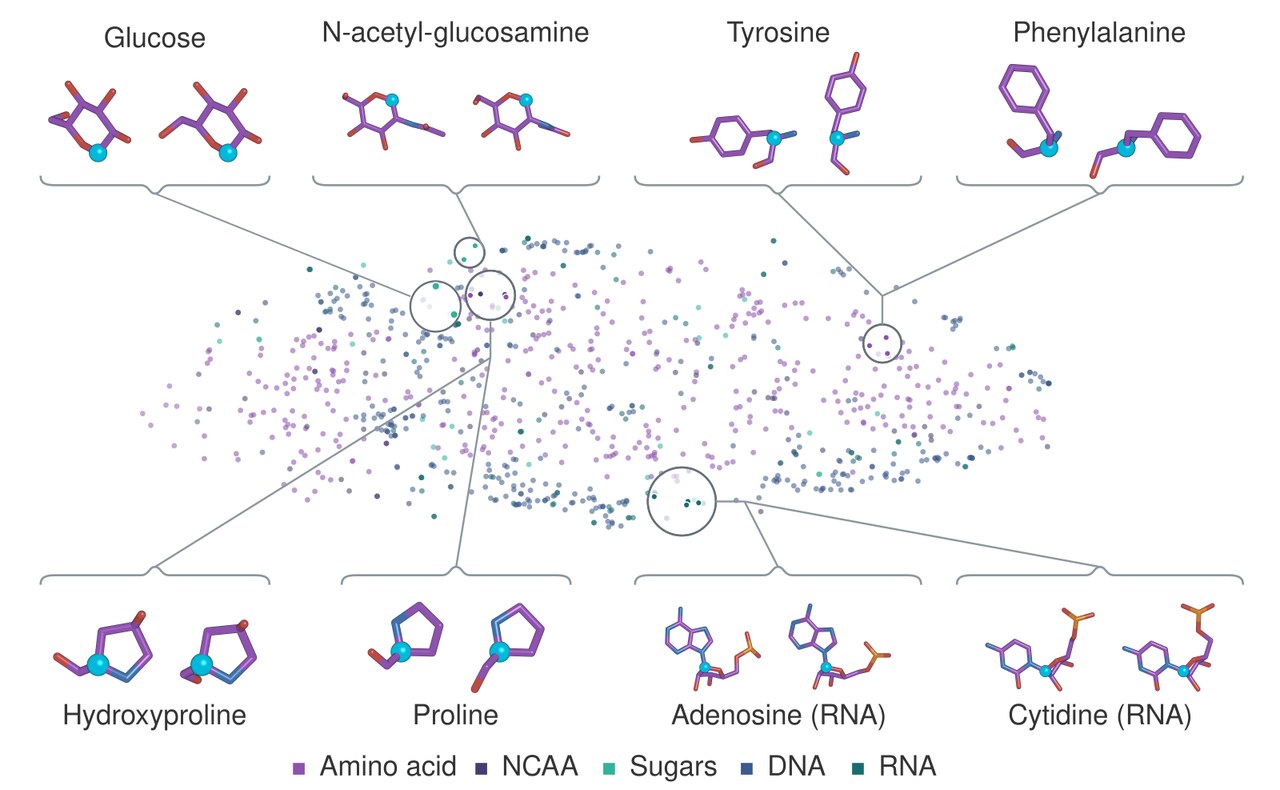
把蛋白质比作一栋房子,骨架决定承重,侧链决定门锁与接口。若先搭骨架、再补细节,局部化学要求可能与整体折叠互相冲突。PANDA 尝试同时确定残基身份与原子几何,让“用什么材料”和“放在哪里”在同一步生成中完成。
PANDA 用嵌套树组织原子槽位,从占位几何读出氨基酸身份,并以原子间距离约束功能基序。论文报告了结构自洽与基序搭建的计算结果,为端到端全原子生成提供了一条新路线。接下来值得关注的,是这类几何精度如何转化为催化活性。
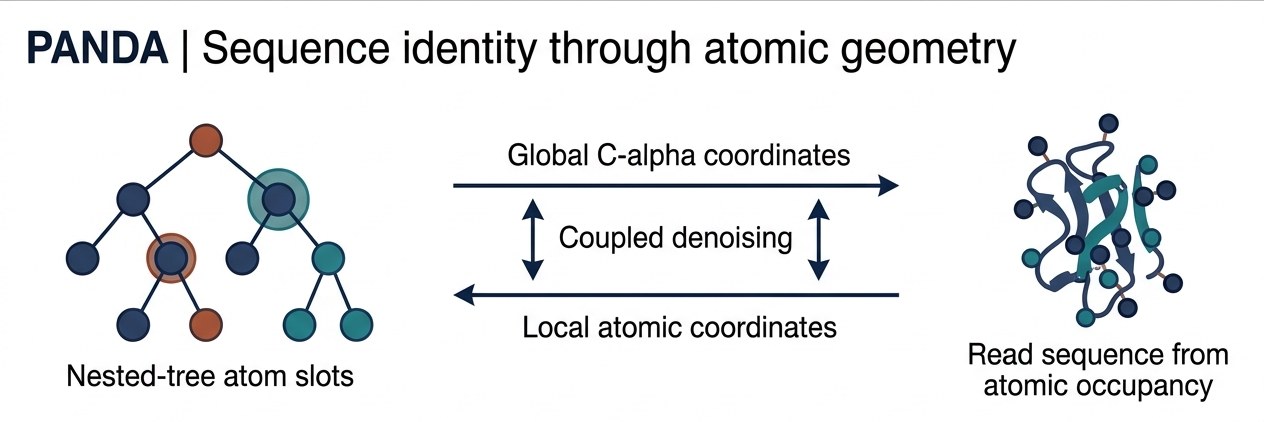
协同生成也未必要求所有变量同时起跑。CODesign 联合处理序列、骨架和局部原子配置;面向环肽的 DC-Flow 则选择先让骨架成形,再启动序列和侧链生成。两种路线都在回答同一个问题:怎样减少不同层级之间相互拆台?
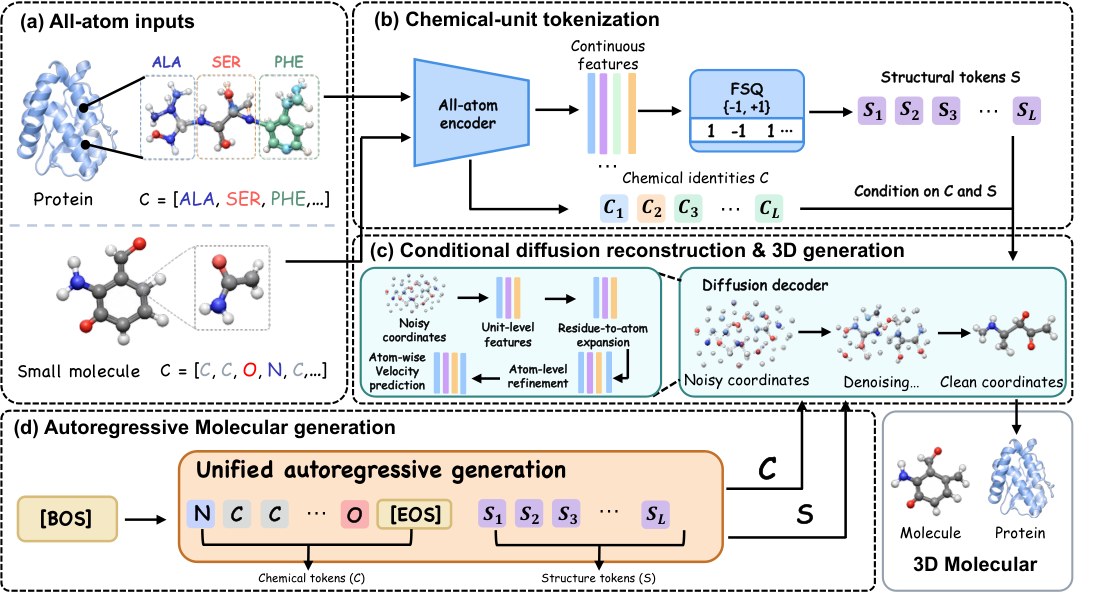
ADT 像给复杂结构制作压缩编码,用紧凑 token 支持原子级重建;Zatom-2 探索跨有机、无机体系的原子预训练迁移。表示能力的提升,为后续功能设计提供了更细的底座。这些工作把“全原子”从口号变成了可操作的编码与生成对象。
模型继续长大,还是让已有模型合作?
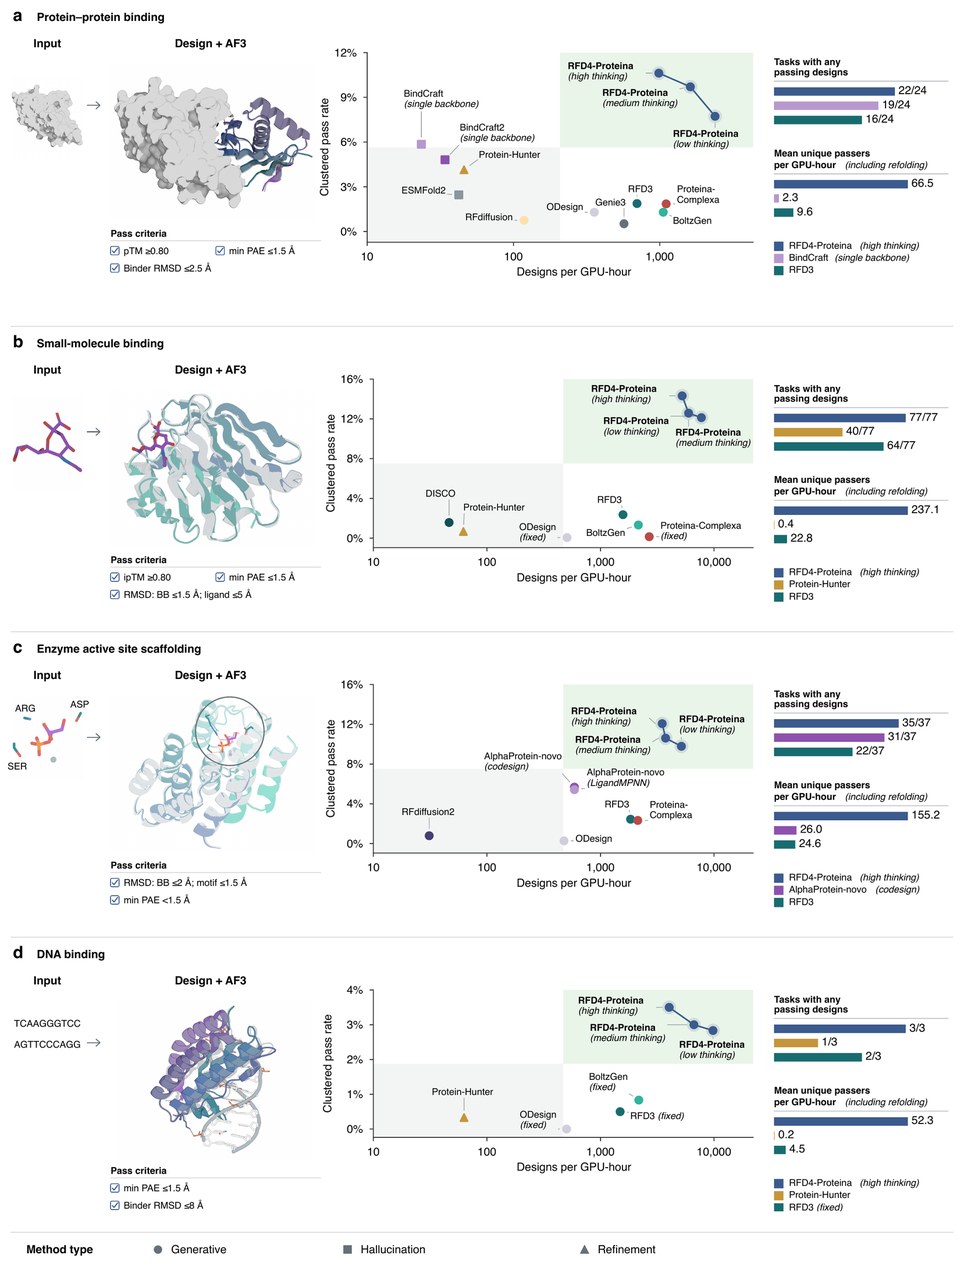
RFD4-Proteina 给出了更统一的方案:将不同化学组分的身份和构象装入共享潜空间,再结合空间锚点生成。它还加入反复细化与奖励引导搜索,把推理时多花多少计算,也变成设计变量。“生成一次”因此不再是固定成本的动作。
官网一组计算对照中,增加思考强度使蛋白结合设计的聚类通过率从 7.7% 升至 10.6%,生成吞吐量从每 GPU 小时 2388 个降至 986 个。模型卡另注明:其发布的效率基准采用较早检查点,未在 10 月 19 日版本重测。阅读这些数字时,版本与计时口径需要一并保留。
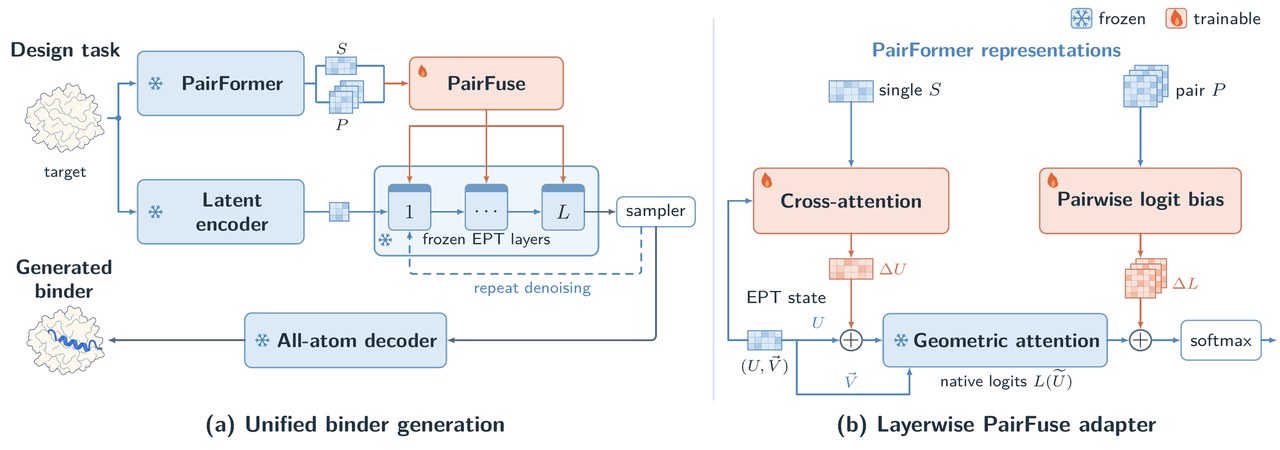
另一条路线像连接两台已有机器。PairFuse 冻结 BoltzGen 的 PairFormer 与 AnewOmni 的几何生成模块,用约 403 万个可训练适配器参数传递信息。这种轻量改造让已有能力快速组合,而不必从零训练一套新模型。
TorchCraft 与 RFOptimization 把结构预测器反过来用于设计优化。前者通过冻结预测器优化序列变量,并报告部分结合物实验;后者组合搜索、优化与筛选。框架的成绩同时依赖底层模型和筛选规则,复用与组合,正在成为另一种竞争力。
一句话的需求,怎样变成可检验的设计?
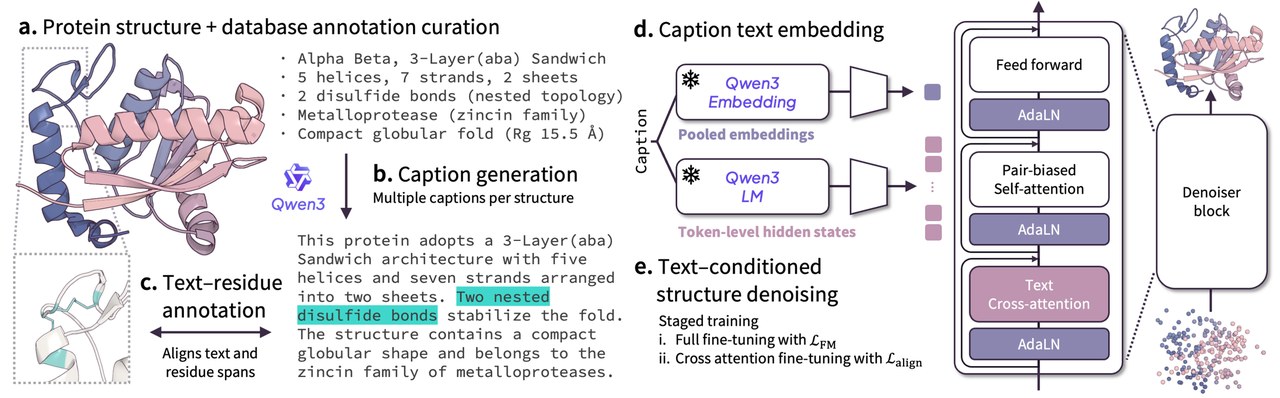
如果说原子约束像工程图纸,自然语言就像需求单。Prompteina 在 Proteina-Complexa 上加入文本条件,团队构建约 180 万个结构、5240 万条描述的配对资源。这让“设计一种能结合某靶点的蛋白”第一次有了可直接输入模型的表达形式。
在 GM2A 案例中,团队从 90 个入选设计中实际检测了 89 个,获得 9 个结合物;最佳设计的总体表观 KD 为 107.4 nM。这是语言条件设计的一次完整概念验证,从文本输入走到了实验结合。
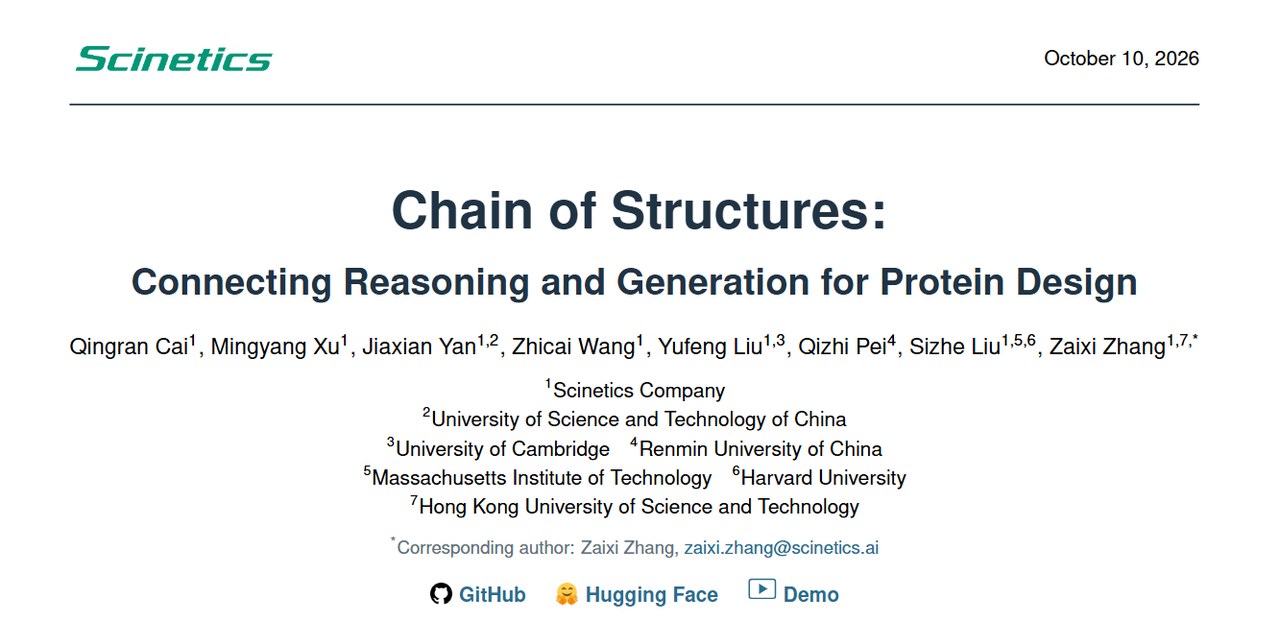
语言控制的难点,是把模糊愿望拆成结构约束。“设计一种酶”需要先回答催化什么反应、底物怎样摆放、局部几何由什么骨架支撑。可检查的中间状态,让一句流畅解释有机会变成可靠结构。
Chain of Structures 把过程拆为催化核心、活性位点、全局骨架和完整序列结构四轮。团队报告 57.0% 的 EC3 类别一致率、0.729 的 TM-score,在计算指标上领先多数对照。结构推理链能否带来更好的酶,活性测定将给出答案。
化学细节开始决定,设计究竟有没有用
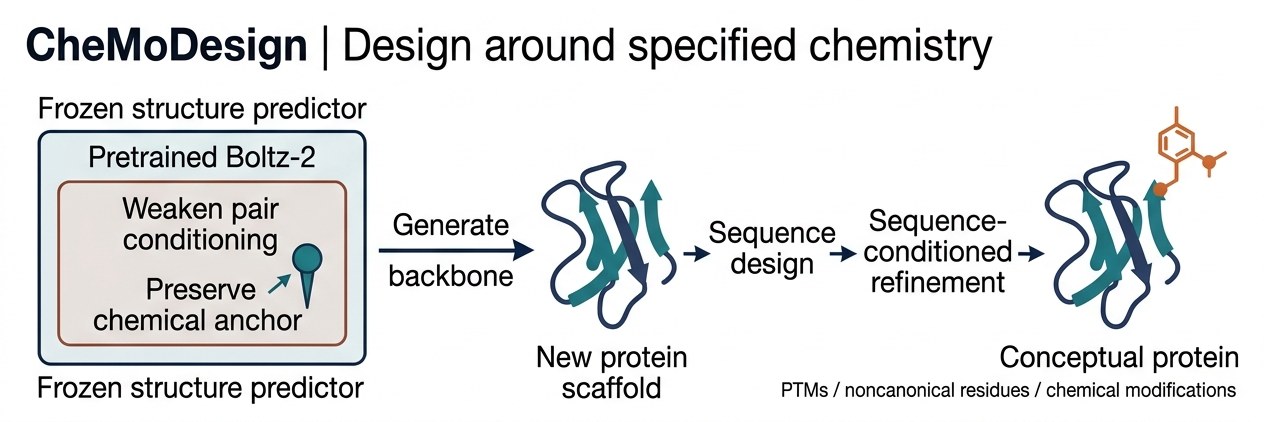
CheMoDesign 将化学要求当作不能随意移动的锚点:复用冻结的 Boltz-2,弱化部分成对条件,再围绕指定化学组分生成与细化。这条路线的重点,是保留特殊化学条件时仍能设计周围蛋白,让非天然氨基酸、翻译后修饰和表达后化学改造进入设计空间。
团队展示了化学修饰相关结合、开关和共价捕获等实验案例;其中 CAIX 结合物的表观 KD 为 45 nM。化学空间的扩展,让蛋白设计开始触及真实药物化学中的关键修饰。
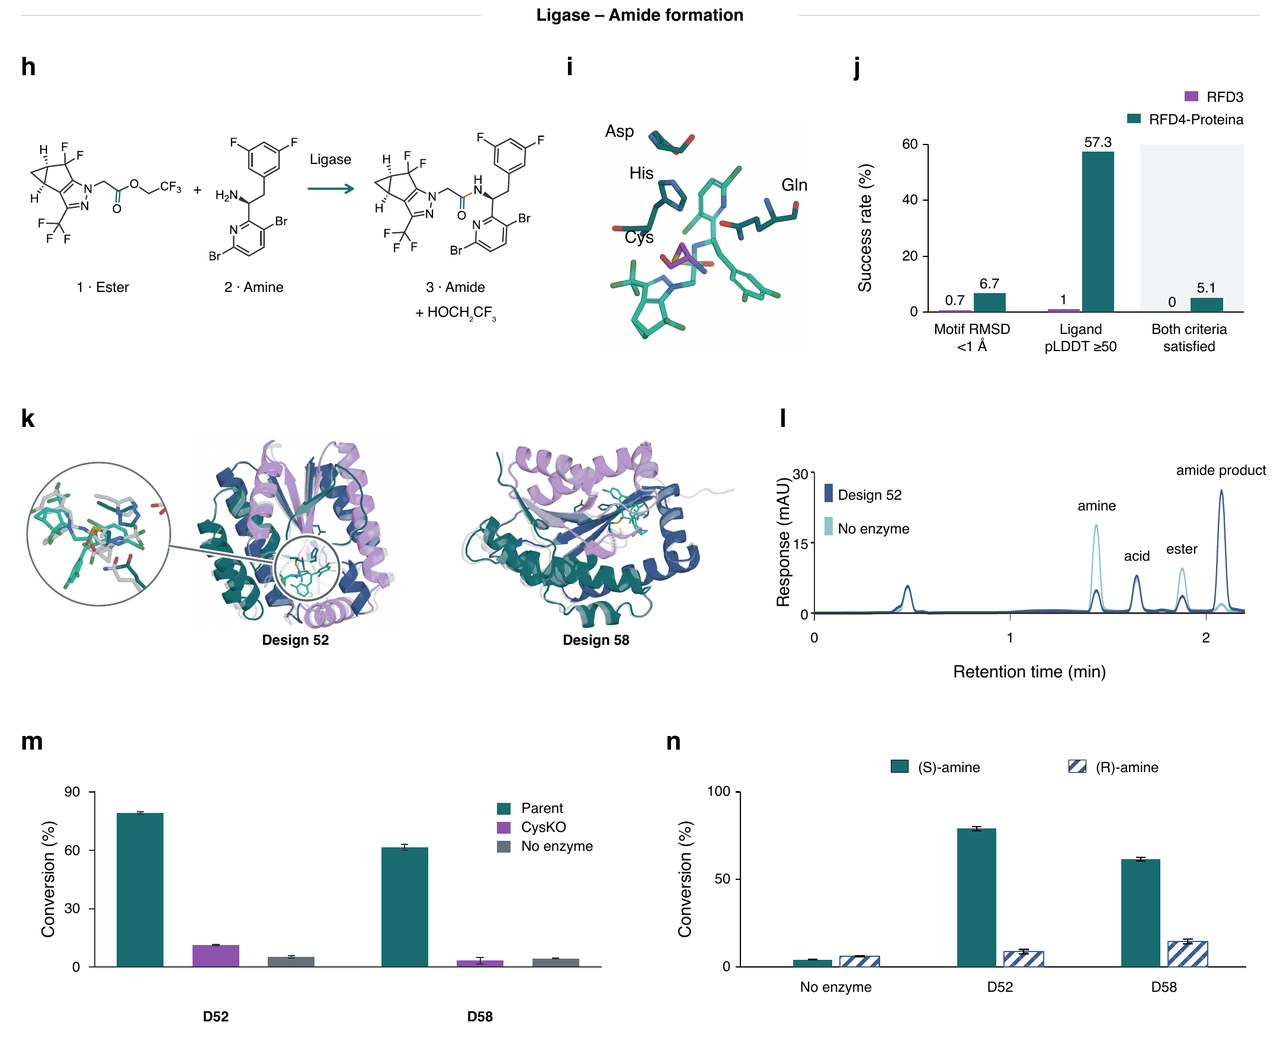
RFD4-Proteina 的连接酶案例,则把要求推向了具体反应。团队报告 67 个设计中有 4 个形成高于背景的酰胺产物;较早一轮 RFD3 设计为 0/72。两轮设计的背景与流程不同,这一对比更适合看作进展信号,而非严格头对头。
其中 Design 52 对 S 型胺的转化率为 79.0%,对 R 型为 8.8%,显示出实验条件下的立体选择性。这一步反应属于 lenacapavir 合成路线中的一环,原子级设计的价值,最终要落到可测量的化学差异上。
抗体能结合之后,还能让细胞做什么?
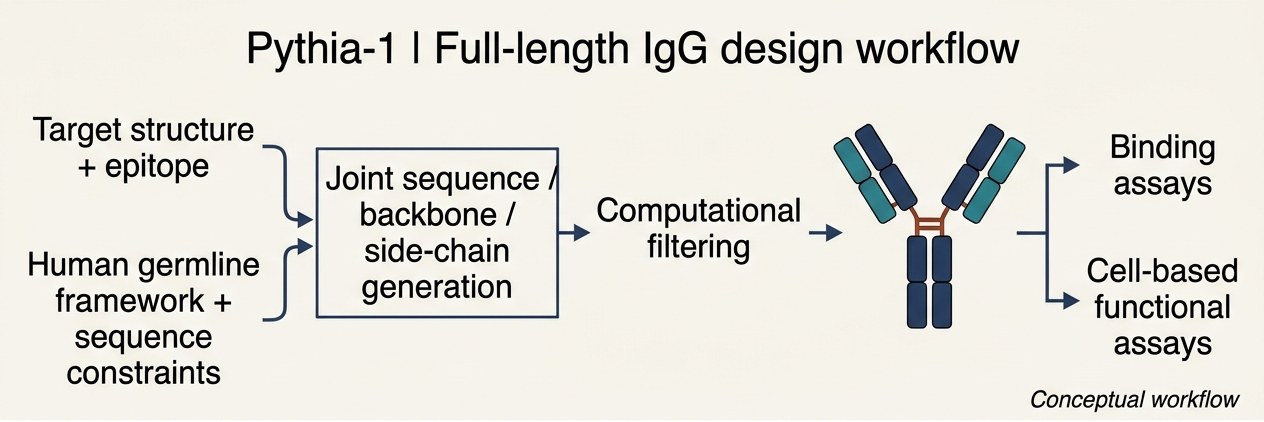
Pythia-1 将序列、骨架与侧链联合生成,并结合人类胚系约束,以全长 IgG1 进行评价。这项工作的看点,在于把结合、细胞功能和部分可开发性评价放进同一条验证链。
团队覆盖 15 个可溶性或胞外结构域靶点与 7 个 GPCR 靶点;初筛在前一组的 8 个、后一组的全部 7 个靶点上获得命中。每靶点最多实验筛选 48 个,前面已有大量计算生成与筛选,计算与实验的分工清晰可见。
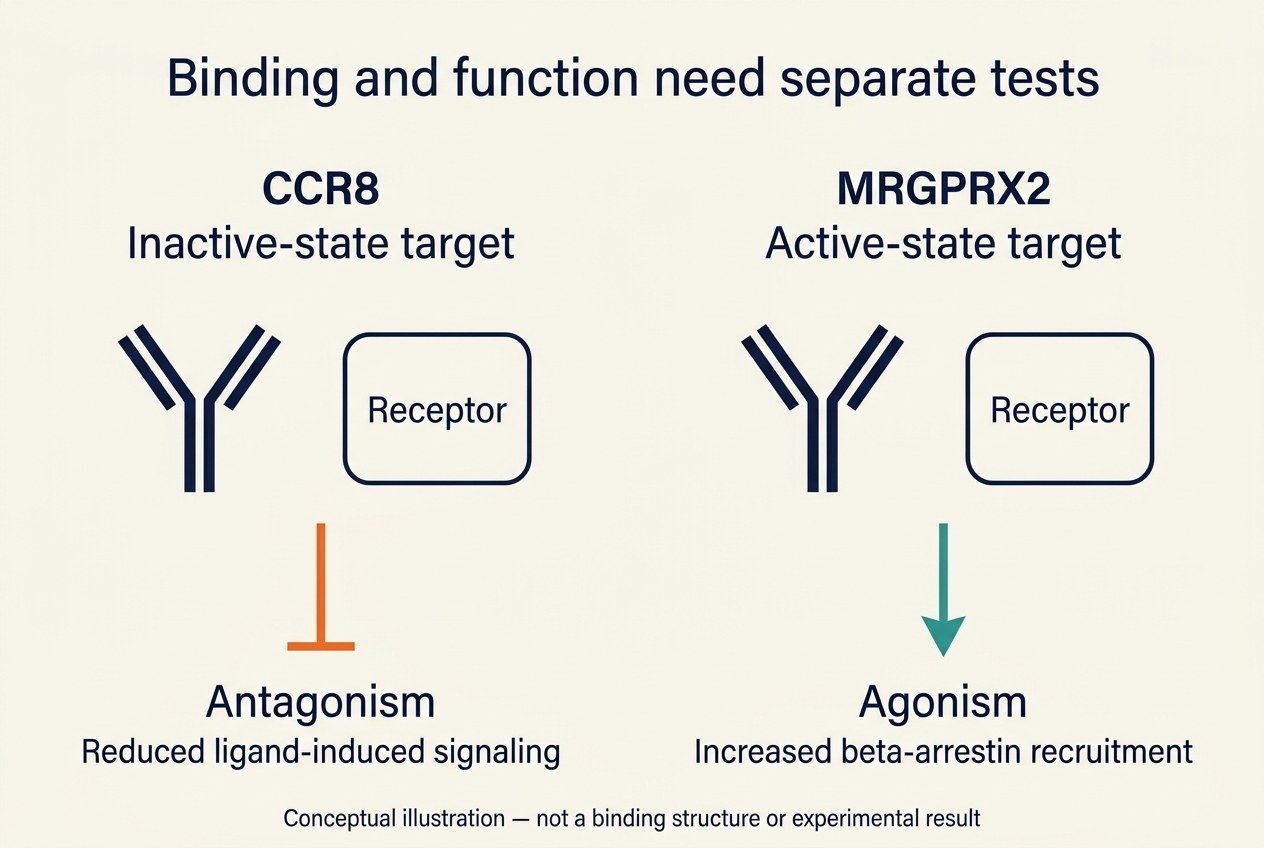
更值得关注的是作用方向。针对非活化态 CCR8 的设计可抑制配体诱导信号;针对活化态 MRGPRX2 的设计可诱导 β-arrestin 招募。结合受体和改变信号,是两个分别验证的结果,细胞结合 EC50 与结合 KD 也对应不同实验。
同一张验证清单,还包括稳定性、聚集、表达与体内表现。Pythia 团队报告了部分体外和生物物理评价,为后续动物疗效、药代与安全性研究打下了基础。高亲和力与正确作用机制,让设计向临床起跑线靠近了一步。
名字都带原子,任务却不在同一层
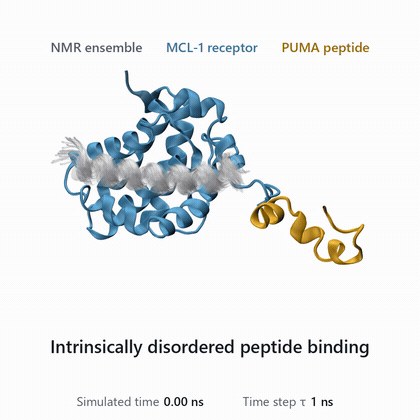
蛋白质更像一段电影,而非一张照片。BioEmu-2 面向结构、平衡系综和时间推进;Zephyr 面向无序蛋白构象系综,在五个体系上展示了快速采样。生成构象分布,与生成新功能序列,是两种互补的能力。
Mol-1 主要承担蛋白、核酸、配体等的复合结构预测;OpenDDE v1.2 增加约束引导的抗体界面推断,权重与检查点格式保持不变。预测器和接口升级会影响设计流程,与生成模型共同构成完整工具链。这也是解读密集发布时值得先做的分类。
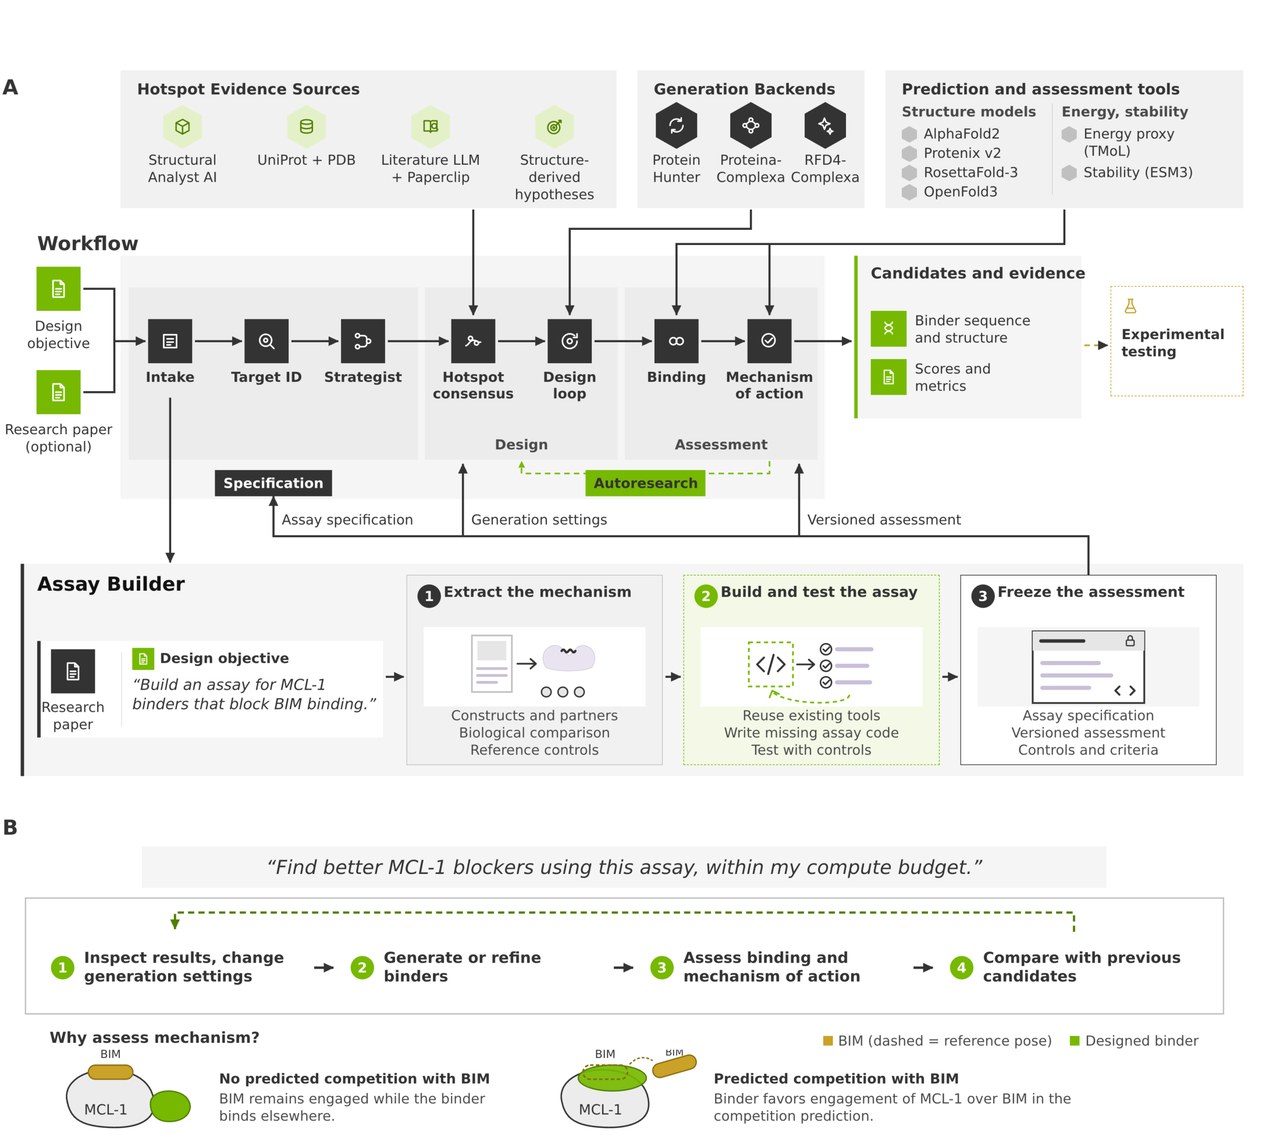
BindClaw 则把问题向上推了一层:先将生物学要求转为固定的机制相关计算检验,再迭代选择生成器、参数与序列。该工作包含人类设计者参与的实验活动,展示了代理框架与人工经验如何协同推进设计。
在钙调蛋白案例中,提交实验的 18 个设计有 15 个结合含钙状态;这 15 个中,13 个在所测条件下未检出对无钙状态的结合。把机制要求写成不会被计算分数钻空子的检验,是这类框架的核心挑战。
下一轮竞争,谁来定义“成功”?
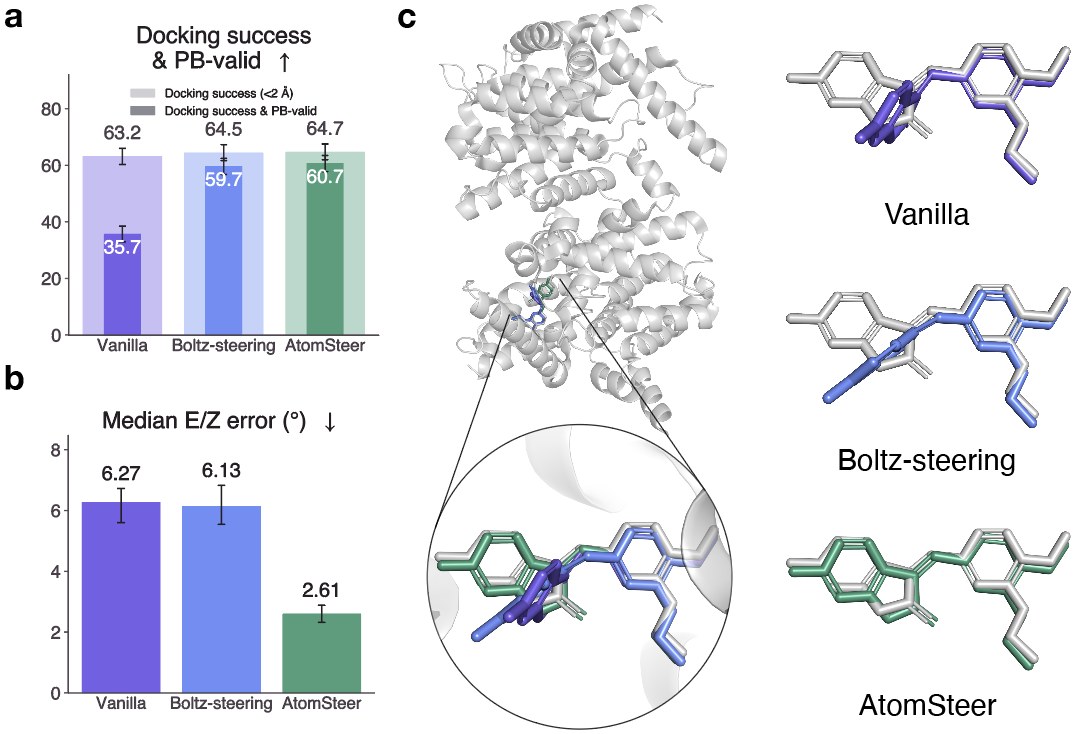
AtomSteer 像给生成过程加上几何限位器,在推理时投影结构约束,无需重新训练。团队在 1103 个复合物的 StereoBench 上报告,对接、有效性与立体化学联合通过率由 36.5% 升至 45.2%,基线为 Boltz-steering。
这组联合指标比“看起来贴近口袋”更严格。全原子评测需要同时问:放得近不近、化学对不对、实验有没有效?图中的对接有效性与 E/Z 角度误差,覆盖了其中部分问题。
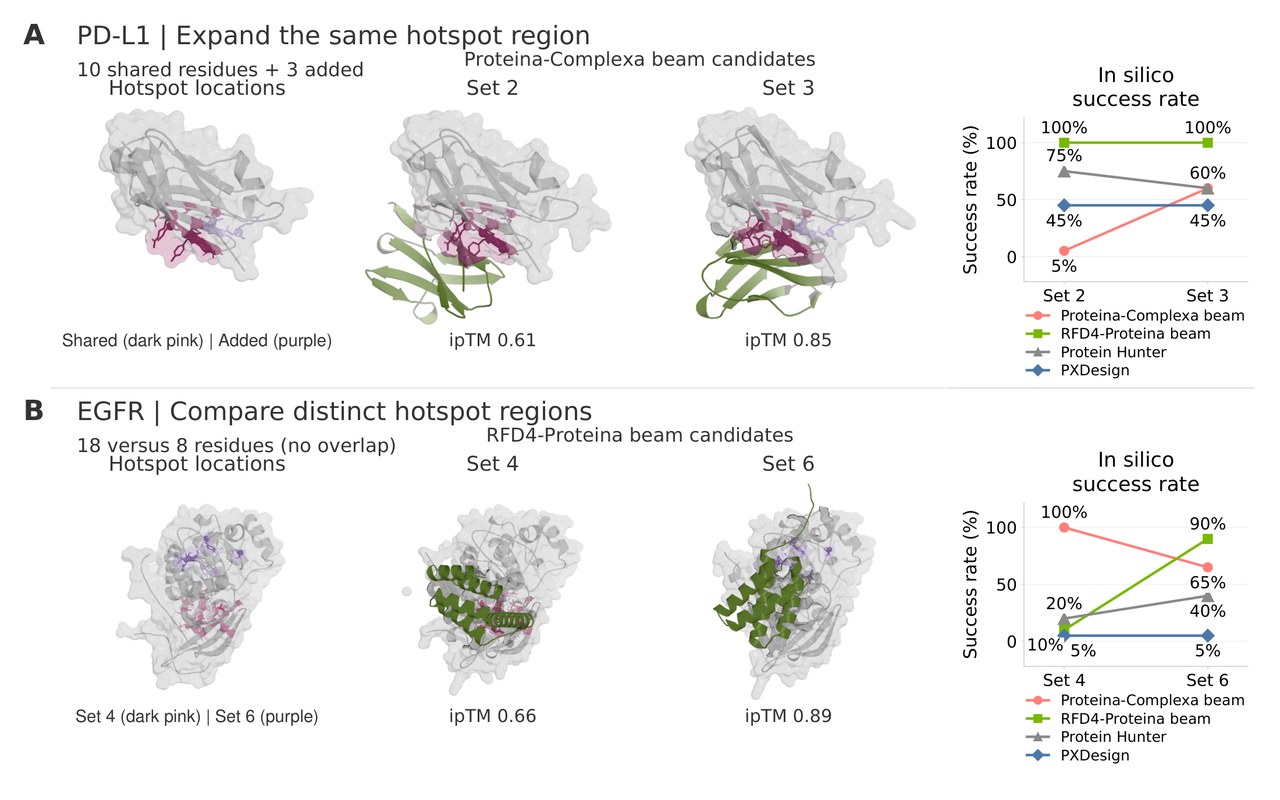
BindClaw 的对照还显示,选对热点可能改变“谁更好”。在 EGFR 两组热点上,Proteina-Complexa 的计算通过率为 100%/65%,RFD4 为 10%/90%,每配置每热点评估 20 个有效样本。这是共同预测器和阈值下的局部比较,也提示评测条件对结论的影响。
预算、热点、后处理与判定阈值,都是成绩的一部分。如果发布只给最佳数字,省掉总生成量与筛选漏斗,读者就难以判断收益来自模型还是搜索。下一轮竞争,也取决于谁愿意把失败样本、成本和评测条件一起摊开。
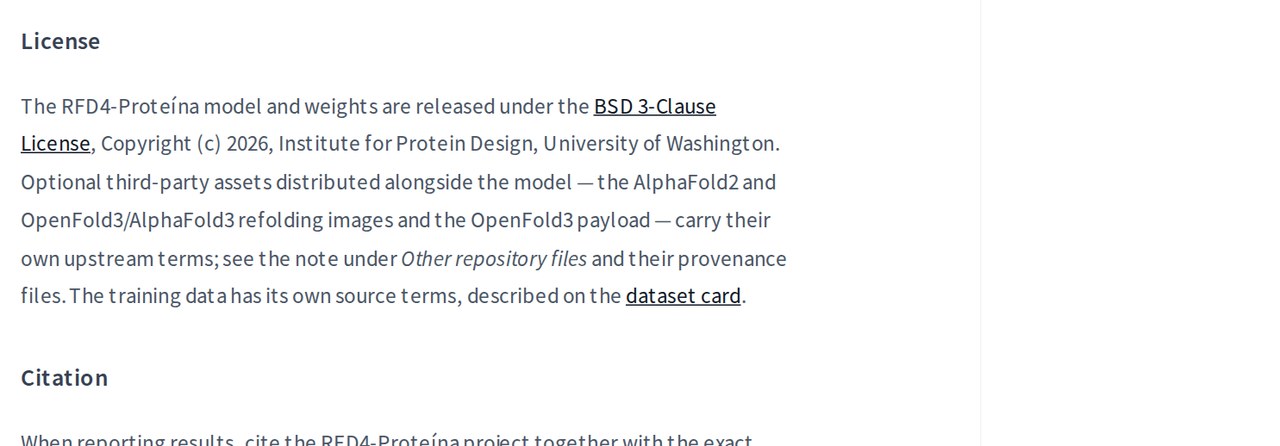
开放性同样要拆开核对。RFD4-Proteina 官方模型卡明确,本体模型与权重采用 BSD-3-Clause;可选第三方资产和训练数据仍有各自条款。代码可见、权重可下载、允许商用,是三个需要分别回答的问题。
本文以截至 2026 年 10 月 31 日的公开材料为界,性能均按研究团队报告表述,未作独立实验复现。预印本、项目页、代码和权重并不同步,“将会公开”不能提前写成“已经可复现”。发布速度可以很快,证据成熟仍有自己的时钟。
可控功能设计仍有许多问题等待解决。当原子细节、语言需求、化学约束与细胞评价开始相接,下一次值得等待的结果,是换一个实验室、换一批靶点后,依然站得住的成功率。