连接 DNA 序列与自然语言的训练数据
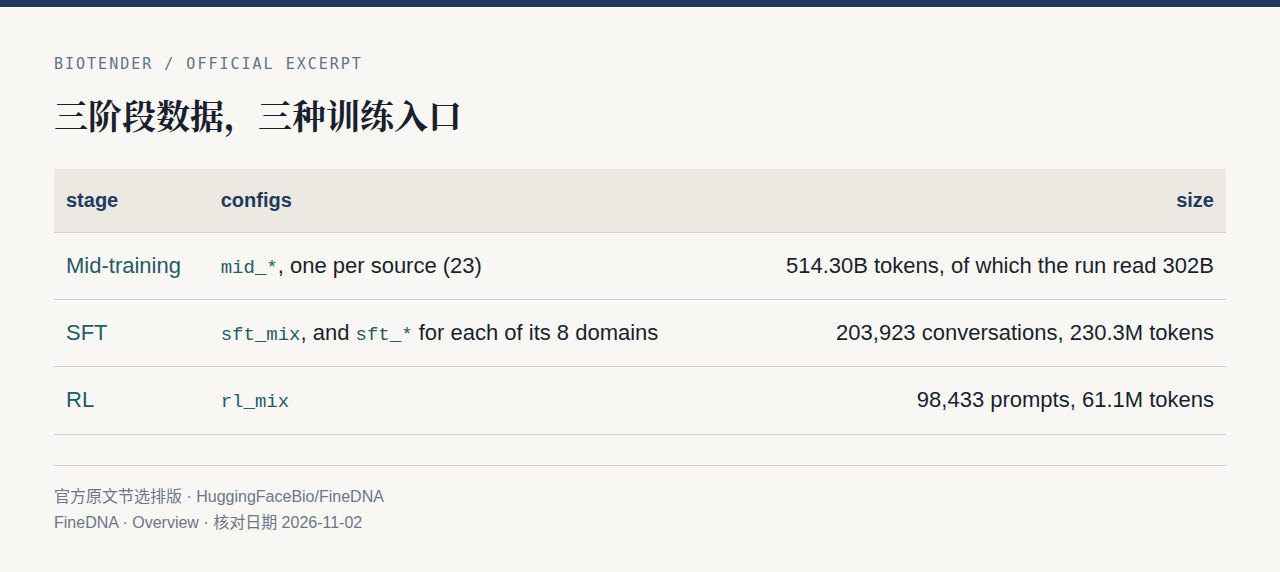
5143亿 tokens 的中期训练数据池、203,923段监督微调对话、98,433行强化学习提示,组成了 FineDNA 的三阶段训练资源。这个由 HuggingFaceBio 发布的数据集,将 DNA 序列、生物学文本和问答任务汇集到同一个入口。
FineDNA 由 Hugging Face、中关村学院与意大利 TIGEM/那不勒斯费德里科二世大学的研究团队合作构建,用于训练基于 Qwen3-14B 的 Carbon-X。研究者可以按训练阶段、数据来源和任务类型分别加载。
从接触序列到回答问题,三个阶段的训练材料都已公开。
把 DNA、论文和通用文本放进同一套配方
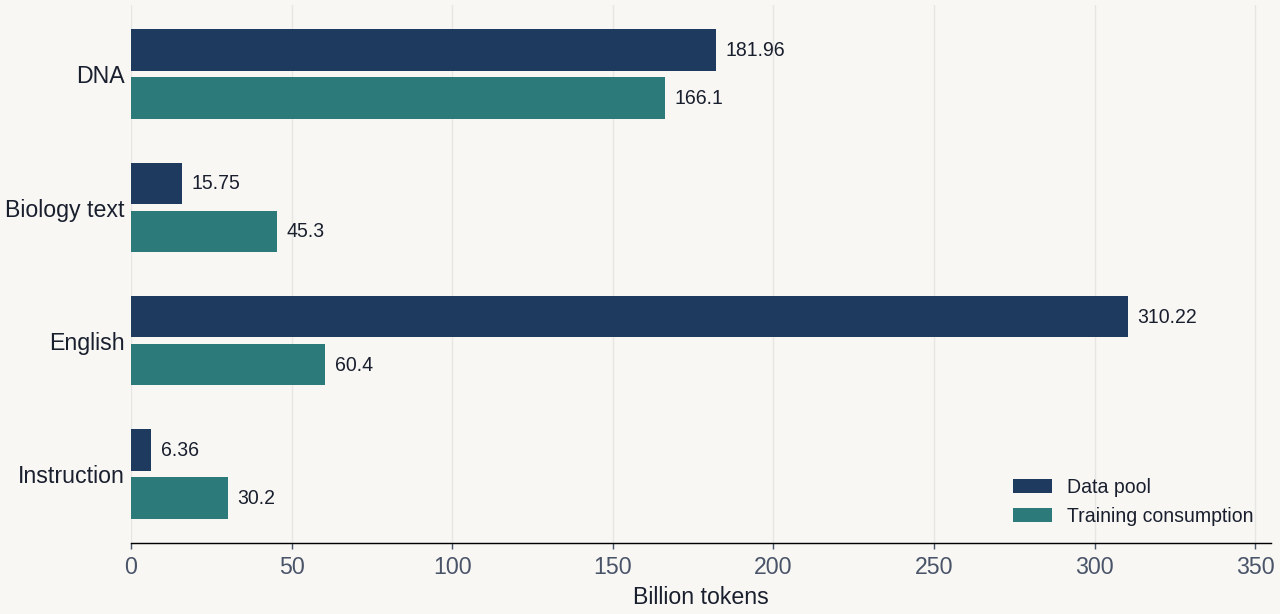
中期训练的作用,是让已有语言模型继续学习 DNA 相关内容。Carbon-X 的配方中,DNA 占训练 tokens 的55%,生物文本占15%,英语占20%,指令数据占10%。序列提供生物学材料,英语和指令数据用于保持语言表达与指令遵循能力。
这套配方可以理解为一张食谱:不同来源按设定比例进入训练。514.30B tokens 是可采样的数据池,Carbon-X 该次中期训练实际读取302B tokens。例如,15.75B tokens 的生物文本被读取45.3B,体现了对这类材料的重复采样。
数据内容与混合比例,共同构成了公开的训练配方。
从基因组序列到带注释的生物文本
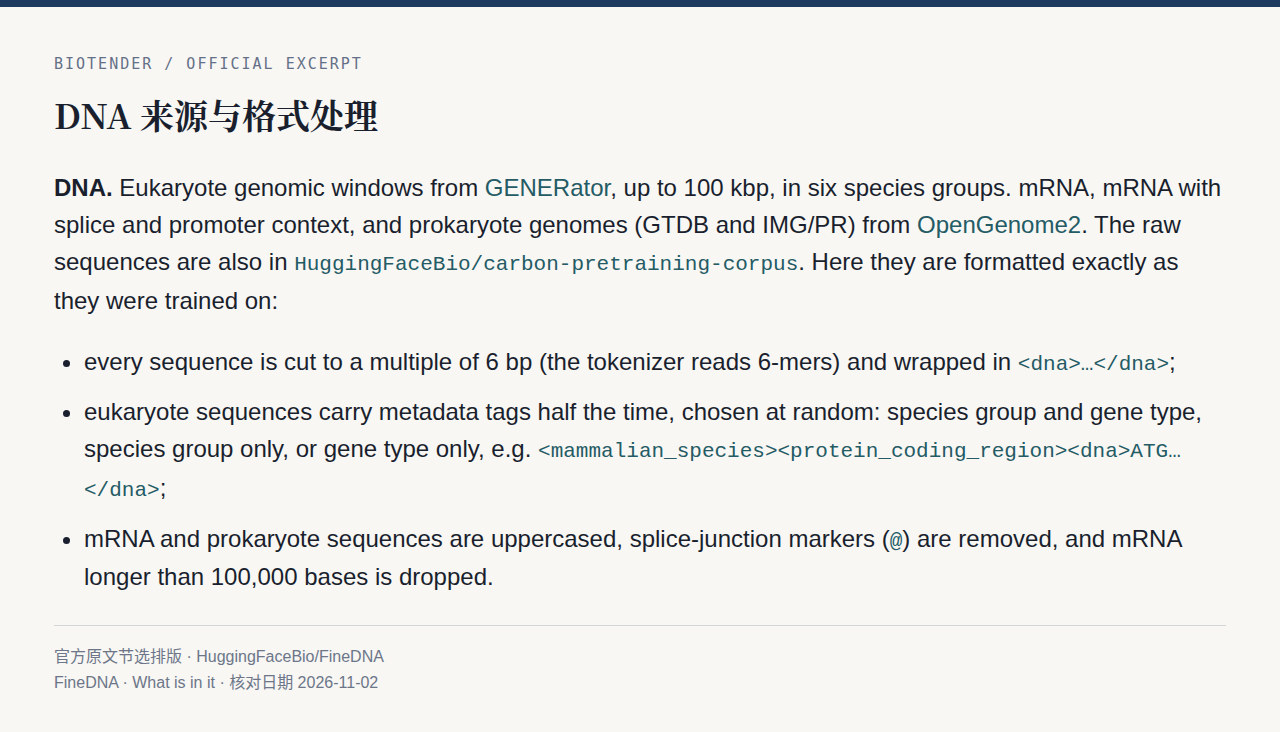
DNA 材料主要来自 GENERator 和 OpenGenome2。其中包括真核基因组窗口、mRNA、带剪接和启动子上下文的 mRNA,以及原核基因组。真核序列又按真菌、原生生物、植物、无脊椎动物、哺乳动物和其他脊椎动物分组。
进入训练前,序列会整理成统一格式。FineDNA 将序列裁到6个碱基的整数倍,并加上 DNA 标记,配合 Carbon-X 的6-mer 分词方式。这相当于把长串碱基每6个分成一组;自然语言部分使用文本分词,共同进入模型的 token 流。
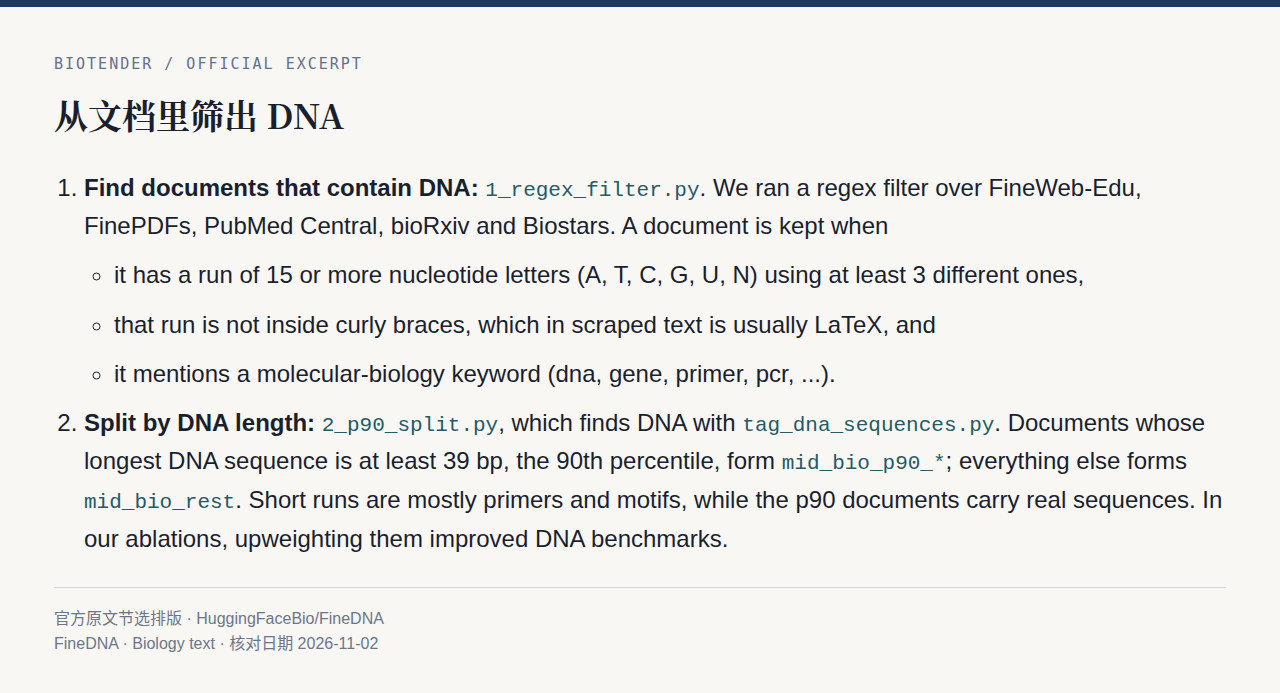
生物文本部分来自论文、网页和社区讨论,包括 PubMed Central、bioRxiv、Biostars 等来源。筛选规则要求文档包含至少15个连续核苷酸字符、使用至少3种字符,并出现分子生物学关键词。这样可以从通用文本里定位含序列的内容。
最长 DNA 片段达到39 bp 的文档会被单独分组,供训练时设置采样权重。数据中还包含 Gemini 为基因组区域生成的描述,以及将文档片段移到末尾、要求模型补全的样本。序列、说明文字和补全任务由此形成了多种训练形式。
用20万段对话连接序列与任务
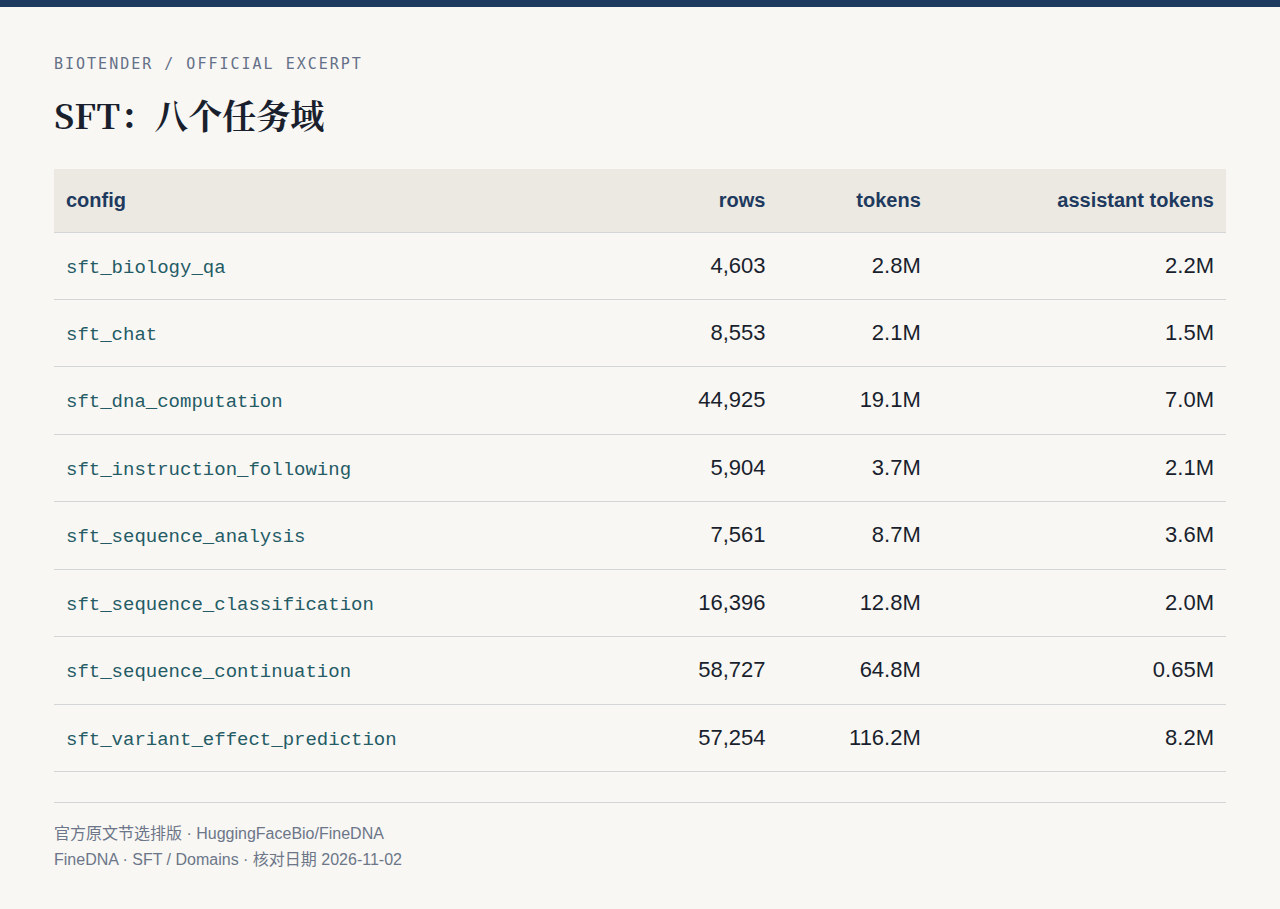
监督微调阶段将训练内容组织成问答和多轮对话。FineDNA 的 SFT 部分包含203,923段对话,覆盖8个任务域。这些任务包括生物问答、普通对话、DNA 计算、指令遵循、序列分析、序列分类、序列续写和变异效应预测。
不同任务对应不同练习:DNA 计算涉及碱基计数、GC 含量、翻译、坐标和序列编辑;序列分类涉及启动子、增强子及物种来源。变异效应样本包含根据序列窗口判断良性或致病的任务,并配有模板化推理文本。
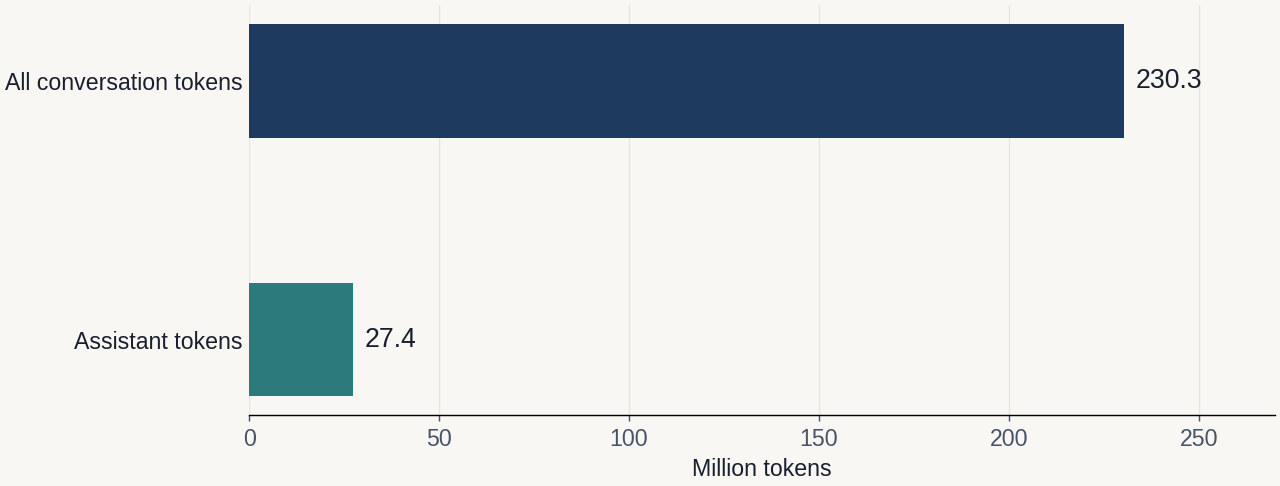
SFT 对话合计230.3M tokens,其中助手回答占27.4M,约为11.9%。官方训练配方在助手回答部分计算损失。输入中的问题与序列提供上下文,助手输出则提供需要模型学习生成的答案。
每条 SFT 数据包含 messages、chat_template_kwargs 和 domain 字段,分别记录对话内容、模板参数与任务类型。使用时保留模板参数,就能沿用每条样本的 DNA 自动标记设置。
对话内容、任务标签和格式参数一起,组成了可直接用于微调的数据结构。
让标准答案与程序参与强化学习
强化学习部分像一套配有“判卷程序”的练习题。每条提示带有标准答案或约束,由代码检查模型生成的回答。任务涉及 DNA 计算、变异效应预测、序列分类、生物知识和指令遵循,DNA 计算类共42,981行。
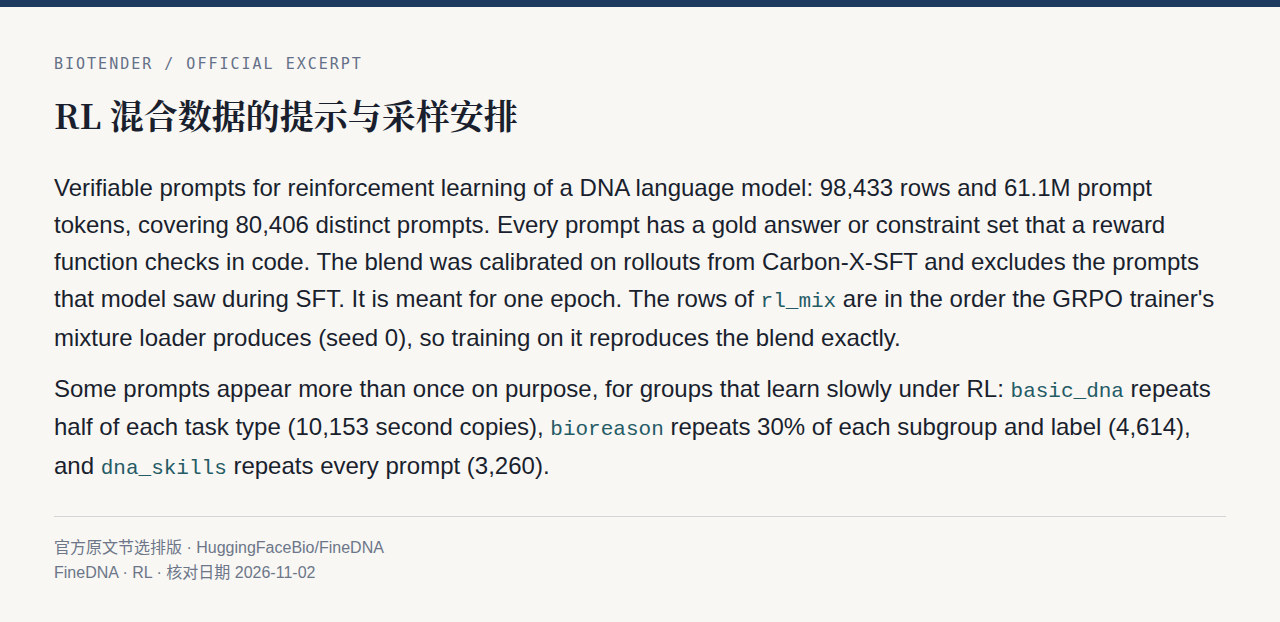
RL 数据共98,433行,包含61.1M 个提示 tokens,覆盖80,406条不同提示。这里的 token 统计对应输入提示,回答在训练过程中生成。与 SFT 相比,RL 采用其中五个任务域,围绕可验证的答案与约束组织训练。
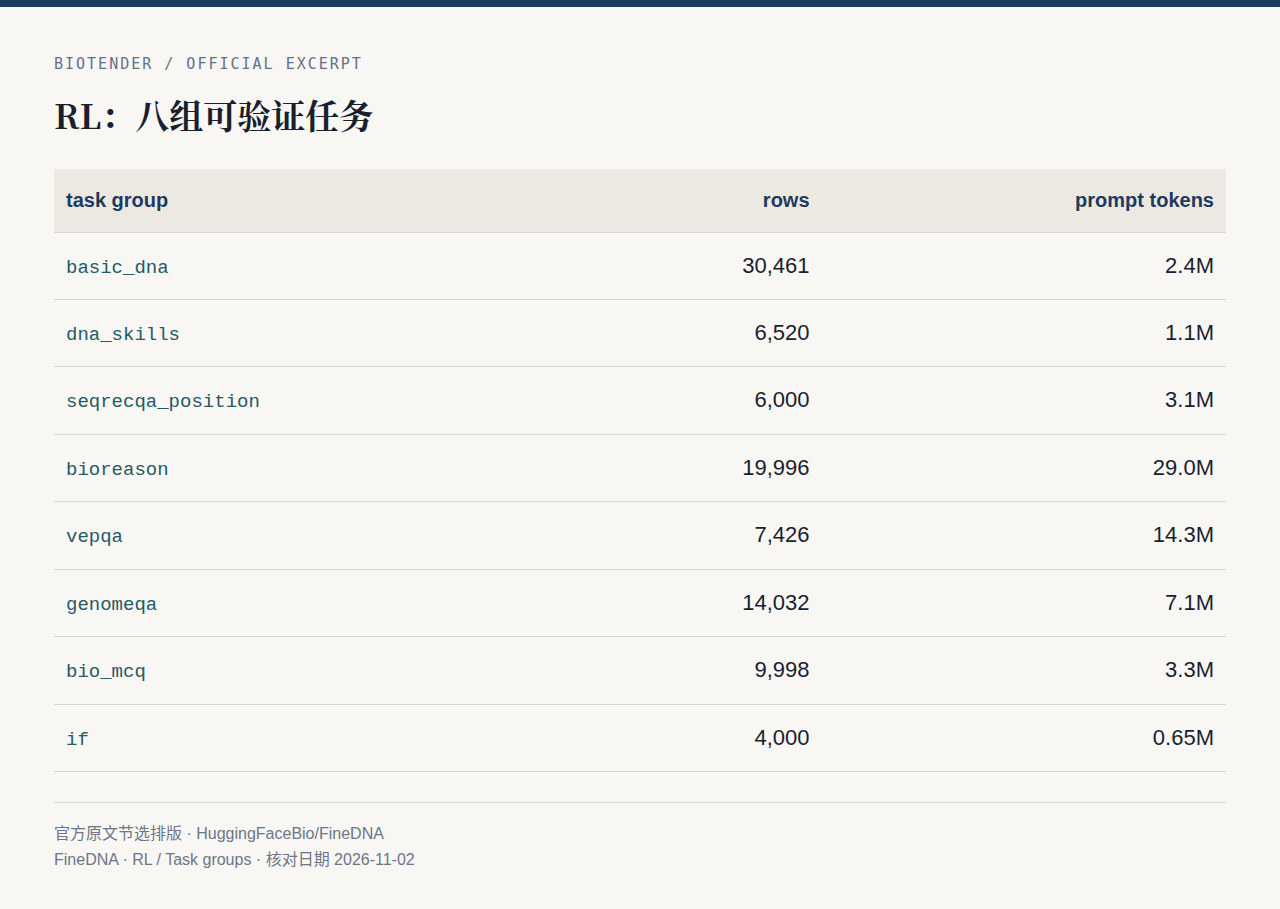
部分提示会按配方重复出现,用于增加相应任务的训练频次。98,433行与80,406条不同提示之间的18,027行差额,来自有意设置的重复采样。例如,dna_skills 中每条提示出现两次;其他任务组也有各自的重复比例。
rl_mix 按官方混合加载器的输出顺序保存,设计为训练一轮。数据字段包括提示、标准答案、任务组、任务类型及验证器所需信息。官方还提供对应的奖励函数,研究者可以结合任务数据和评分代码了解训练过程。
按来源、任务和训练阶段直接取用
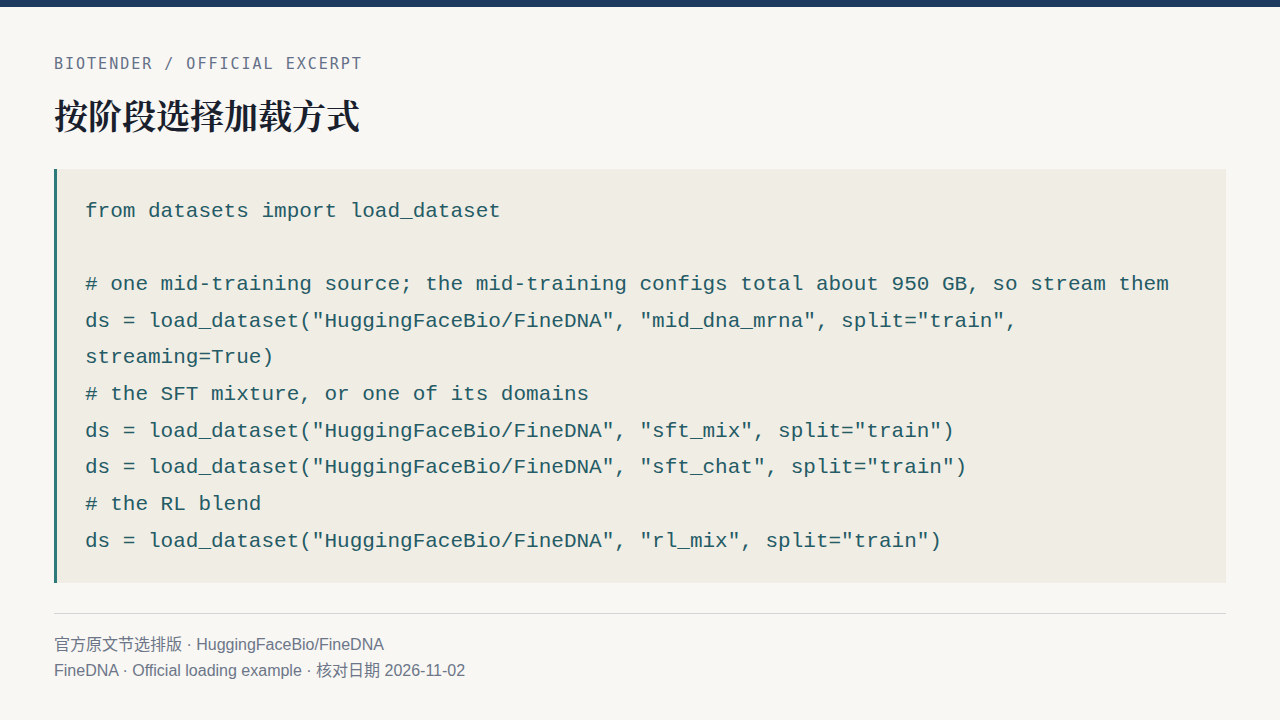
FineDNA 可以通过 Hugging Face Datasets 加载。中期训练部分提供23个 mid_* 来源配置;SFT 提供 sft_mix 和各任务域配置;强化学习数据使用 rl_mix。中期训练配置合计约950 GB,官方示例采用流式读取。
研究者可以先选择一个来源或任务域,查看字段与样本,再接入训练流程。sft_mix 已整理好监督微调的混合样本,rl_mix 则包含强化学习所用的提示与验证信息。中期训练各来源的采样比例,以及三阶段训练脚本,都能在 Carbon 仓库中找到。
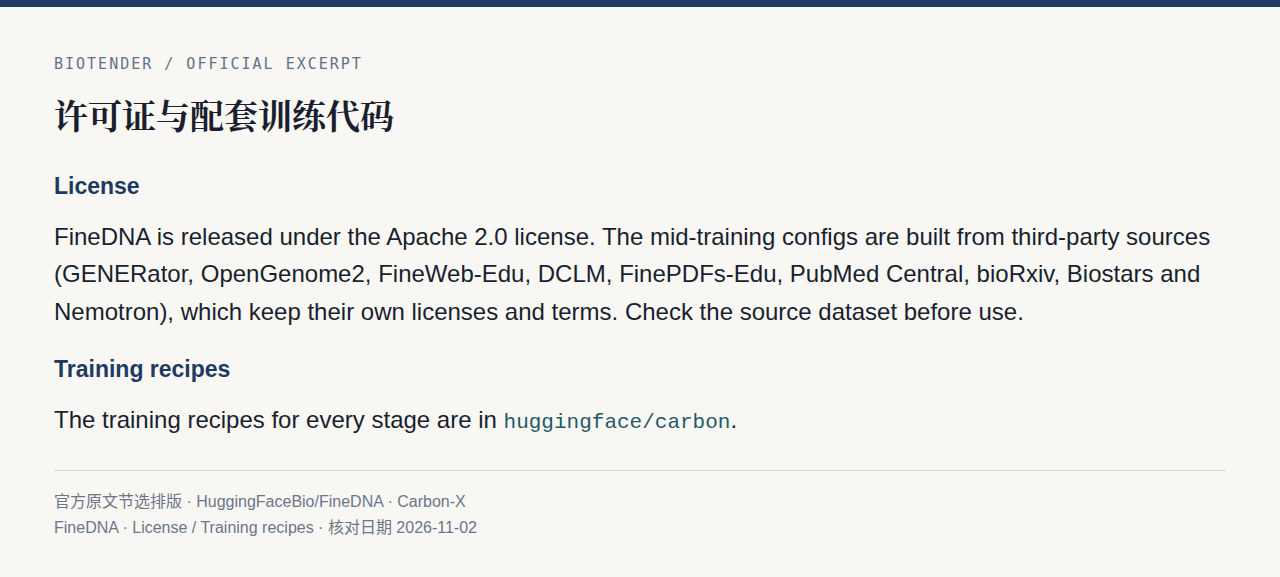
FineDNA 以 Apache 2.0 许可证发布,所引用的第三方来源保留各自的许可证与条款。数据卡列出了主要上游材料,使用时可结合来源说明确认相应条件。数据集页面提供分阶段配置,Carbon 仓库提供配套训练代码与说明文档。
从持续学习 DNA 的中期训练,到按问题作答的监督微调,再到程序评分的强化学习,FineDNA 将三个阶段的材料整理到同一个数据集入口。
研究者可以从其中一个任务域开始,也可以沿着公开配方了解 Carbon-X 的完整训练流程。