4 份技术报告,把腾讯混元的生物模型研发版图从蛋白质延伸到了细胞。HyInv 根据蛋白质骨架设计序列,HyPLM-Flash 提取序列特征,HyFF 计算原子之间的能量与力,HyCell 则把单细胞基因表达转换为可比较的表征。
这条线索与混元科研智能体 Hyra 2.0 的工作方向相连。据腾讯介绍,HyInv 和 HyPLM 均由 Hyra 2.0 从头训练,系统参与了模型训练与推理优化。结合团队的原子级模型和单细胞报告,可以看到其科学模型研发覆盖的不同尺度。
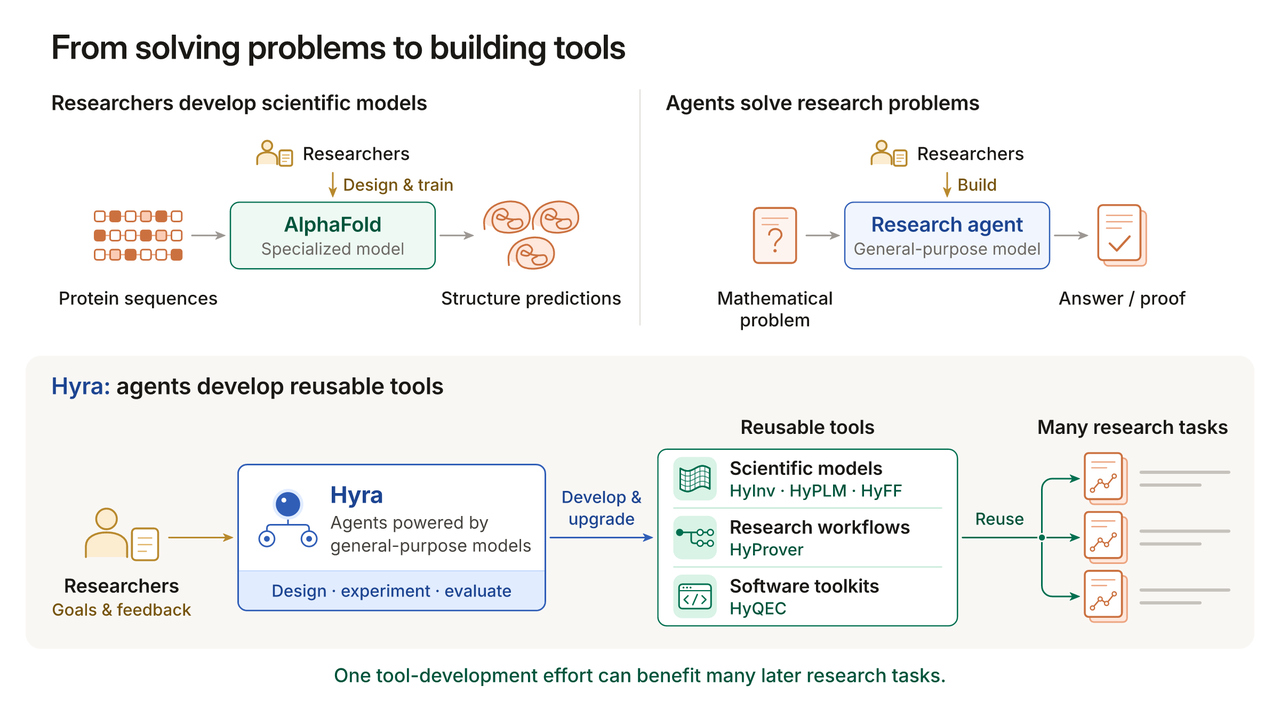
把模型研发拆成可以持续推进的任务
Hyra 2.0 已接入团队的沟通、计算和代码环境。研究者通过企业微信与它对齐需求,系统在计算平台提交实验,在代码仓库实现和验证改动,并保存过程与产物。智能体承担的工作,开始进入科学模型本身的研发流程。
它的组织方式分为三层:Overall 协调目标和资源,Mission 负责研究路线,Worker 执行探索与实验。持久化队列和 Research Board 保存任务进展,独立 Review Worker 参与复核。较大算力开销和共享知识同步操作,按官方说明经过人工审批。

先给蛋白质一副骨架,再为它写序列
蛋白质设计的一类任务,是先确定三维骨架,再寻找能与之匹配的氨基酸序列。HyInv 做的就是这种“按形状写序列”的逆折叠,参数量约 196 万。它读取主链原子坐标,通过消息传递图网络生成候选序列。
训练先使用 627,945 条带结构序列,再加入结构奖励强化学习。研究团队用 ESMFold2 预测候选结构,根据它与目标骨架的吻合程度更新模型。采样时采用“先起草、再改写”:先生成初稿,再分组调整部分位置,逐步形成候选。

报告给出了一项具体计时:单张 H20 上,为 402 残基骨架生成 128 条序列,HyInv 的 BF16 优化路径耗时 50.6 毫秒,ProteinMPNN 发布实现为 2,907 毫秒,约相差 57 倍。计时使用监督阶段权重,取预热后的重复运行中位数,不计加载、编译和图捕获。

把蛋白质序列读成可复用的特征
如果把蛋白质序列看成一段由氨基酸字母写成的文本,语言模型可以学习其中的上下文关系。HyPLM-Flash 是约 6.5 亿参数、32 层的双向 Transformer。它通过遮住部分氨基酸再预测的方式训练,单次输入最长支持 8,190 个残基。
报告记录的两阶段训练合计使用 7260 亿 token,后阶段扩展上下文并加入结构辅助目标。输出的表征可用于下游预测;模型也可按序列似然对突变进行零样本评分。它与 HyInv 分别承担序列理解和骨架条件设计任务。

在单张 H20、2,048 条共同测试蛋白上,INT8 引擎的表征提取吞吐量为每秒 13.1 万个残基,约为同规模参考实现的 1.9–2.7 倍。在 ProteinGym 的 217 组替换突变实验上,报告的零样本 Spearman 相关系数为 0.409;主质量评测采用 BF16。

让原子沿着模型学到的力运动
从序列走到分子运动,需要描述原子之间如何相互作用。HyFF 输入原子种类、坐标、总电荷和自旋信息,预测能量,并由能量梯度计算力。这些力用于推进分子动力学轨迹,让模型成为原子级模拟中的机器学习力场。
HyFF 在 OMol25 数据上训练,覆盖 83 种元素,提供从约 230 万到 12 亿参数的五档模型。它把计算分配给不同距离的邻居,压缩原子间消息,并让每个原子调用对应元素的更新网络,以控制单步模拟开销。

团队在完整 OMol25 验证集上比较误差,并在单 H20、2,586 原子体系上计时。HyFF Andante 的力误差为 7.65 meV/Å,UMA-S-1.2 为 7.55;对应单步耗时分别为 29.5 和 860 毫秒。按这一设置,Andante 在相近力误差下约快 29 倍。
较大的 Largo 每原子能量误差为 0.364 meV,DPA4-Pro 为 0.380 meV,报告中单步耗时分别为 123 和 1,190 毫秒。团队采用各模型官方支持的快速配置,部分基线误差取自已发表结果。HyFF 使用键约束,DPA4/DPA4C 无约束运行。HyFF 将不同规模的模型,放在同一套速度与误差坐标中比较。

在应用案例中,Presto 对包含 58,560 个原子的 AqpZ 水通道膜体系进行了 100 纳秒无偏模拟。报告展示了水分子在孔道中单列排列,以及偶极方向在 NPA 基序附近翻转;50–100 纳秒期间,记录到 77 次完整穿孔事件。这些观察来自计算轨迹。

把一个细胞的表达谱,压缩成 512 维坐标
团队的另一份报告把研究对象推进到单细胞。可以把每个细胞的基因表达谱理解为一张高维指纹,模型将它转换成便于比较的坐标。HyCell 是总计 1,610 万参数的单细胞转录组表征模型,用六层 Transformer 输出 512 维向量。
训练时,解码器接收数据集和供体编码,供体判别器进一步约束表征中的供体信号。这一设计旨在保留细胞状态、减少技术和来源差异。提取新细胞表征时,编码器只读取表达计数,无须输入批次或供体标签。

报告使用 CELLxGENE Census 的人类细胞数据,排除评测和开发集相关来源后,留下 532 个数据集、7,950 万个训练细胞,训练约 640 亿 token,用两张 H20 耗时 9.9 小时。HyCell 用千万级参数,学习跨数据集的单细胞表达表征。
在七个未参与预训练的图谱上,HyCell 的综合分数为 0.735,按批次分组推理的 Stack 为 0.736。综合分数同时考虑生物信息保留、批次校正和注释迁移;其中 HyCell 的生物信息保留分数为 0.700,SCimilarity 为 0.699。

进一步的生物分析采用覆盖 12 名供体、17 个组织部位的免疫图谱。将其中 2,778 个 CD4 T 细胞分为两组,HyCell 与初始/中央记忆、效应/效应记忆状态标签的 ARI 一致性分数为 0.64。其他模型表征和 PCA 在这项二分任务上至多约为 0.03。
在 3,751 个 B 细胞至浆细胞相关状态的细胞中,扩散拟时序与阶段顺序的 Spearman 相关系数为 0.937。这项分析衡量表达表征能否恢复已知分化阶段的顺序。报告还用解码器读出基因表达程序,并展示了有标签参考集上的注释微调。

目前,官方仓库已列出 HyInv、HyPLM-Flash、HyFF 的权重、推理代码与技术报告;HyCell 报告介绍了表征提取、表达解码和注释微调接口。从给定骨架设计序列,到推进原子运动,再到比较细胞状态,这组工作呈现了混元科研团队在不同生物计算任务上的模型研发进展。