107 个候选分子,17 个在体外实验中达到抗菌命中标准。2026 年 10 月 29 日,一项名为 MolRSI 的研究以预印本形式发布于 arXiv。研究团队报告,其筛选流程的实验命中率为 15.9%,此前专家主导流程为 8.7%。
这项来自东北大学、Broad 研究所等机构的合作,把注意力放在发现流程本身:选什么模型,怎样组合,下一轮改哪里。MolRSI 将这些尝试保存成可复用的经验。一次任务产出的经验,可以参与下一次任务的决策。
让 AI 连同“发现流程”一起设计
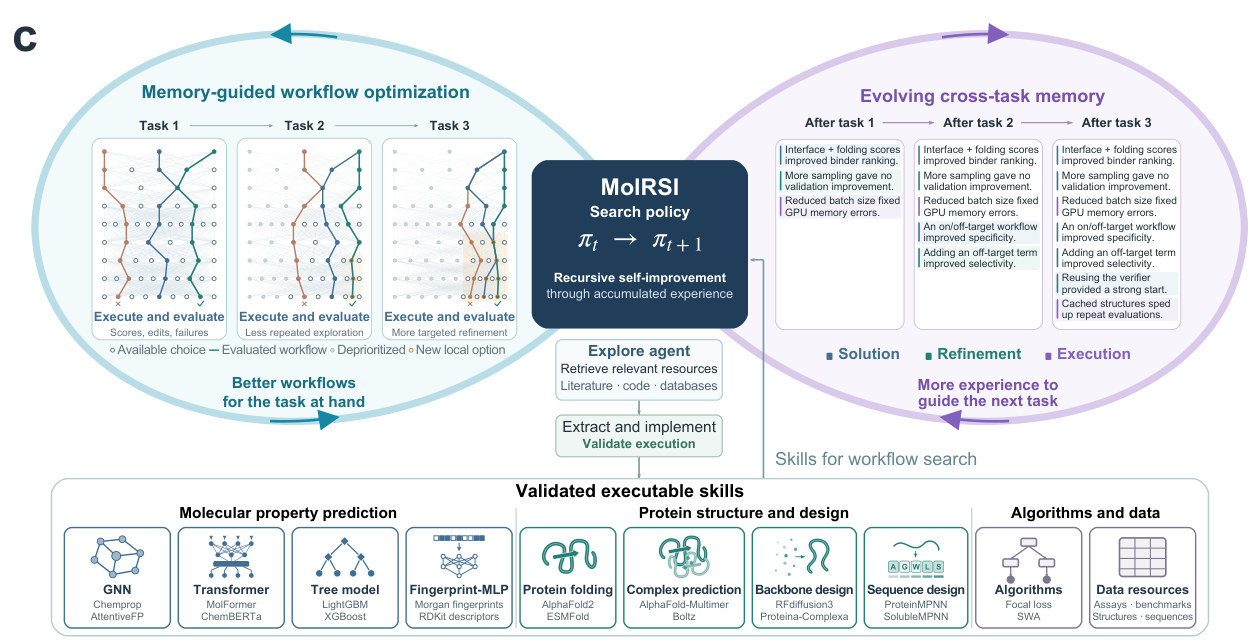
分子发现像搭建一条生产线:上游处理输入,中间预测或生成,下游排序、筛选。每一段都有多种选法,组合起来就形成庞大的搜索空间。MolRSI 把整条工作流当作优化对象,连模型架构、训练方式和组件组合都可以调整。
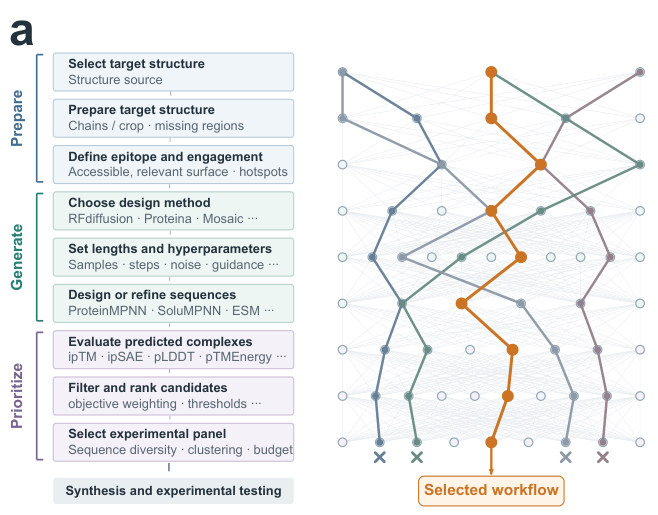
它先派出 Explore Agent 查找论文、代码和工具,将资源整理为“可执行技能”,写明依赖、输入输出与使用步骤。新技能首次使用时要经过运行验证,报错后尝试修复,通过后才留作复用。抗菌预测和蛋白任务的资源库分别包含 110 项与 65 项技能。
让经验有地方存,也有机会被用上
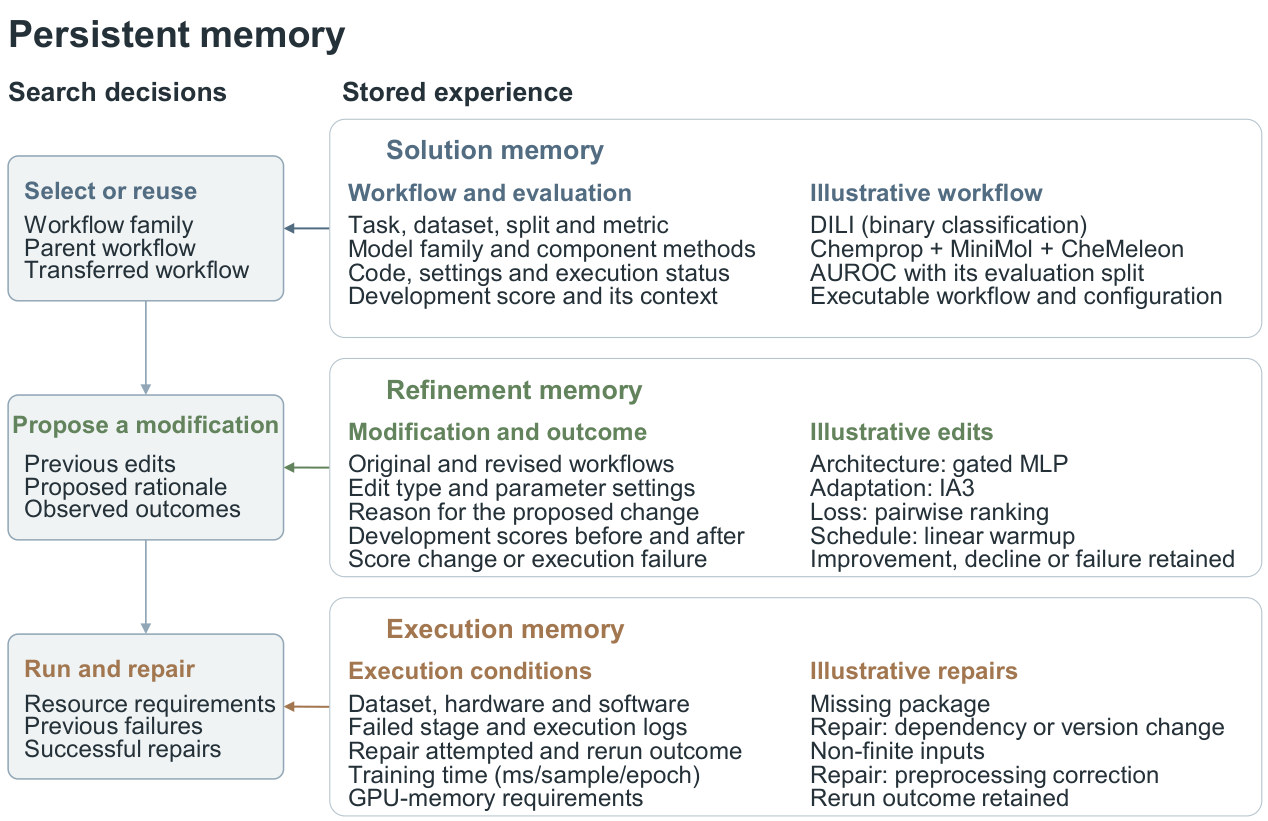
可以把 MolRSI 的记忆理解为三本相互关联的实验笔记。第一本保存“什么方案有效”,记录工作流代码、配置和开发评分。第二本保存“改了什么、结果怎样”,同时留下提升、下降和失败。方案记忆与改进记忆,让成功路径和尝试过程都能被检索。
第三本记录“怎样顺利跑完”:运行时间、显存需求、依赖冲突和修复结果。面对类似错误,智能体可以调取已经奏效的处理方式。这些记录带着任务、数据和评估条件一起保存,因此经验能与具体场景对应。测试集成绩不参与搜索决策或记忆更新。
有了笔记,下一步是决定往哪里试。MolRSI 像沿着分岔路逐步探索,使用蒙特卡洛树搜索:每个节点对应一个工作流,修改产生新分支。当前任务成绩、探索奖励和相关任务经验共同影响选择。每次运行再回写记忆,继续改变后续搜索。
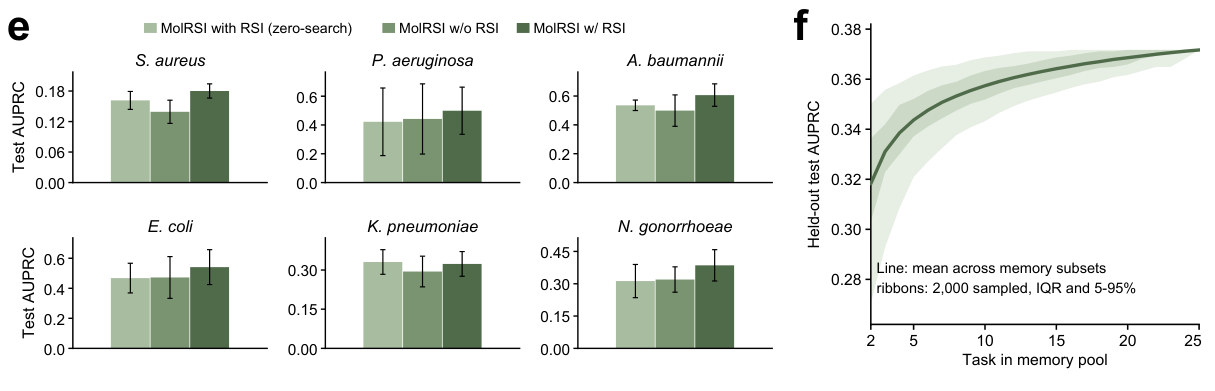
研究团队先用 25 项分子性质与细胞毒性任务积累经验,再迁移到 6 项抗菌预测任务。引入跨任务经验后,6 项任务的平均测试 AUPRC 均提高。部分任务直接复用旧配置,也优于从零搜索;此时仍需用新任务数据训练和验证。“自进化”在这里落实为:经验改变搜索,搜索继续产生经验。
从 1207.6 万个分子中,挑出值得实验的一小批
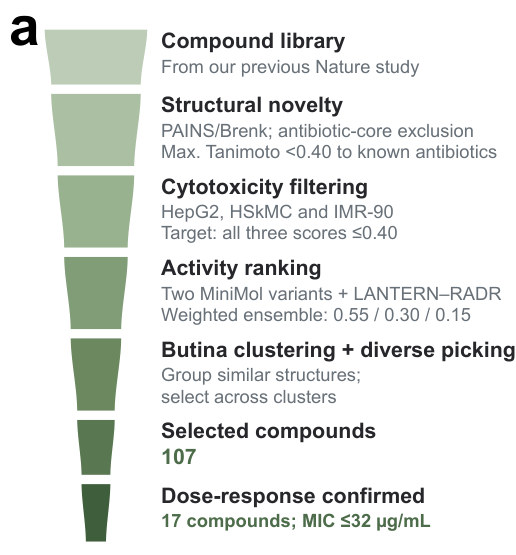
抗菌筛选同时关心几个目标:抑菌能力、对人细胞的毒性,以及结构新颖性。MolRSI 使用与此前专家研究相同的训练数据和 12,076,365 个化合物组成的筛选库。它先处理结构新颖性,再预测细胞毒性和抗菌活性。
最终的活性排序融合两种 MiniMol 变体和一个 LANTERN–RADR 集成模型。随后,流程把相似结构聚成组,再跨组挑选,保留化学多样性。这一套筛选、排序和挑选步骤,最终形成 107 个进入实验的候选分子。论文也记录了最终挑选中的细胞毒性筛选例外。
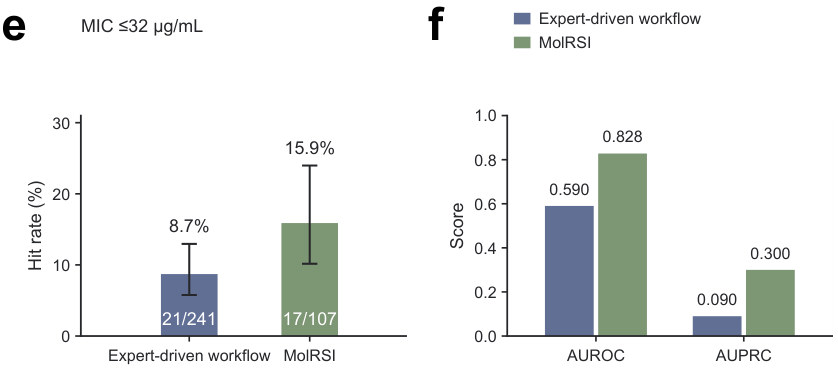
实验中,17 个分子对甲氧西林敏感金黄色葡萄球菌(MSSA)的最低抑菌浓度不高于 32 μg/mL。按这一标准,MolRSI 的命中比例为 17/107,即 15.9%;此前研究为 21/241,即 8.7%。两次筛选的观察结果,呈现了不同完整流程的产出。
团队还把预测模型放到同一批 271 个保留测试化合物上比较,减少候选挑选差异对评价的影响。MolRSI 的 AUROC 从此前模型的 0.590 提高到 0.828,AUPRC 从 0.090 提高到 0.300。这给实验命中结果补上了共同测试集上的预测证据。
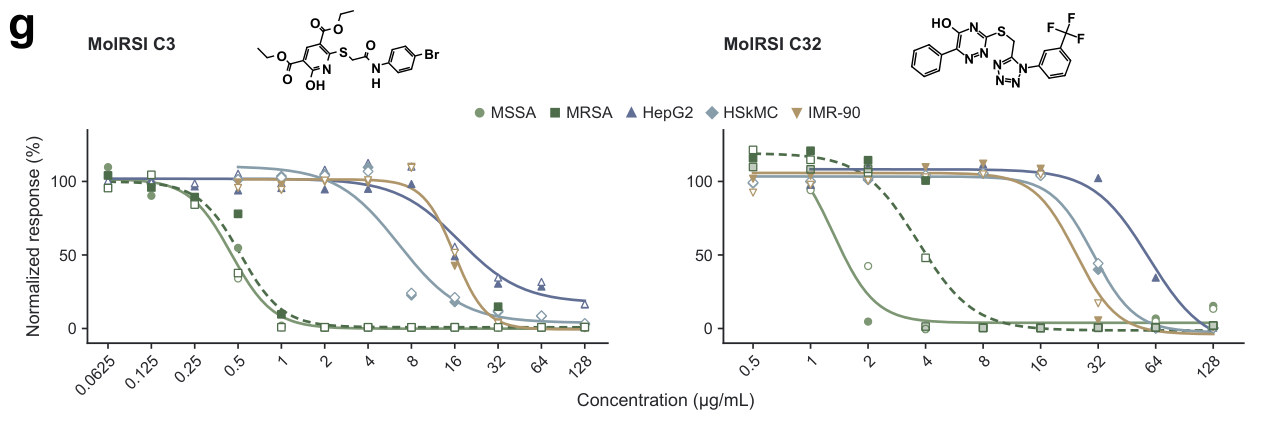
两个具体候选让结果更直观。C3 和 C32 对耐甲氧西林金黄色葡萄球菌(MRSA)的最低抑菌浓度分别为 1 μg/mL 和 8 μg/mL。这里的耐药菌活性来自进一步实验,与前面统计整体命中率所用的 MSSA 指标分开报告。
在人肝细胞系、骨骼肌细胞和肺成纤维细胞检测中,C3 的半数细胞毒性浓度为 6.4–17.5 μg/mL,C32 为 24.2–54.7 μg/mL。两者在所测条件下呈现出抗菌活性与细胞毒性之间的浓度间隔。这为后续优化提供了起点,当前结果仍属于体外验证。
小蛋白要认出“托盘上的那一小段肽”
第二条验证路线转向蛋白设计。MHC 可以理解为细胞表面的展示托盘,托着一小段肽。设计结合蛋白时,同一个托盘换一段肽,就可能成为需要避开的对象。因此,pMHC 设计要兼顾目标结合和肽段区分能力。
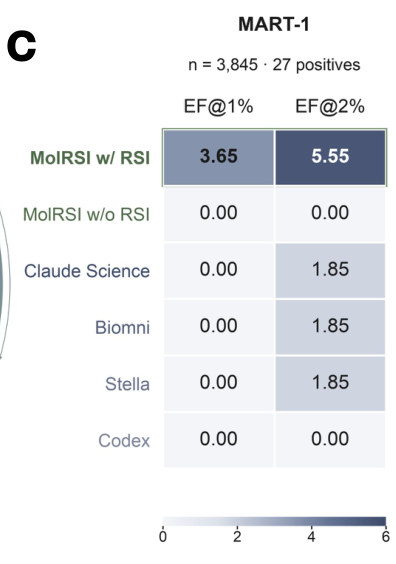
MolRSI 先从 14 项小型结合蛋白排序任务积累经验,再用两组 gp100 数据开发 pMHC 排序流程,将 MART-1 留作测试。带经验的流程在前 1% 和前 2% 候选中的富集倍数为 3.65 和 5.55;无跨任务经验时均为 0.00。富集倍数衡量前排候选相对全库的阳性集中程度。
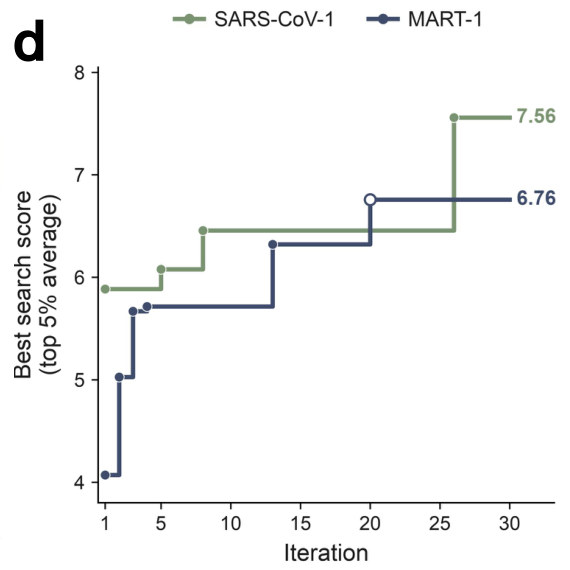
随后,团队固定已经选出的排序流程,分别针对 MART-1 和 SARS-CoV-1 的 pMHC 开展最多 30 轮生成工作流搜索。智能体调整生成方法和配置,以排名前 5% 候选的平均计算评分引导优化。对应的脱靶复合物保留同一 MHC,仅更换展示肽。
两项任务的最佳搜索评分分别达到 6.76 和 7.56,较初始配置提高约 66% 和 28%。这里改善的是候选生成流程的计算目标,后续再由实验检验选出的设计。先学会怎样挑,再用这套标准指导怎样造,是这条设计路线的关键。
八个实验命中,让工作流走到实验台
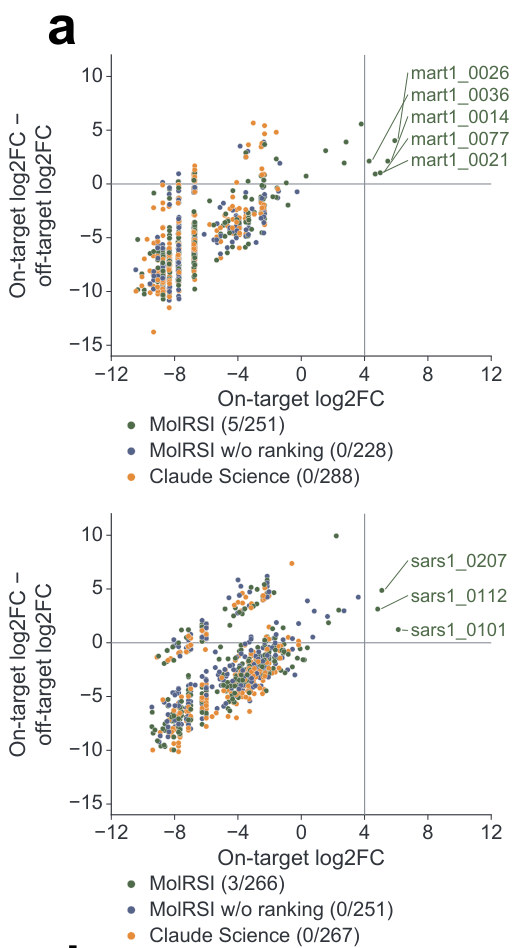
候选通过噬菌体展示体系接受两轮体外筛选。命中要求目标富集的 log₂FC 大于 4,并高于已测脱靶的最高可测富集。MolRSI 在 251 个可评估 MART-1 设计中得到 5 个命中,在 266 个 SARS-CoV-1 设计中得到 3 个,共 8 个。
对照也显示了排序环节的作用:移除所开发的排序流程后,两项任务合计 479 个可评估设计未检出命中;Claude Science 对照分别在 288 个和 267 个可评估设计中未检出命中。这些结果支持了针对当前任务优化候选优选流程的价值。
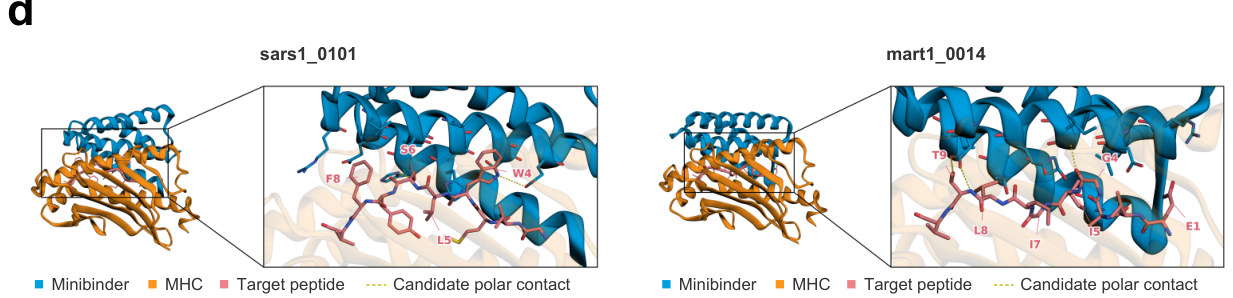
代表性命中的预测复合物中,小型结合蛋白位于暴露肽段上方,呈现与多个肽残基接触的可能。计算结构为识别方式提供线索,实验则建立了富集与对已测脱靶的偏好性。两种证据共同描绘了这些设计,尚不等于治疗效果或全面的特异性验证。
对 MolRSI 而言,每个项目还会留下如何选择、修改和运行方法的记录。论文提出,未来可让实验成败进一步参与搜索策略更新。当实验经验也能持续进入下一轮决策,分子发现智能体的“越用越会做”就有了更具体的推进方向。