2026 年 11 月 4 日,Nature 发表了一项 RNA 基础模型研究。中国科学技术大学、浙江大学等机构的研究人员提出 structRFM,让模型在预训练阶段共同学习 RNA 的序列规律与碱基配对关系。
这项工作围绕约 2,100 万组 RNA 序列—结构数据展开,覆盖二级结构、三维结构适配和多类功能预测。结构信息参与了训练题目的设计,模型通过恢复被遮住的碱基学习序列与结构的联系。
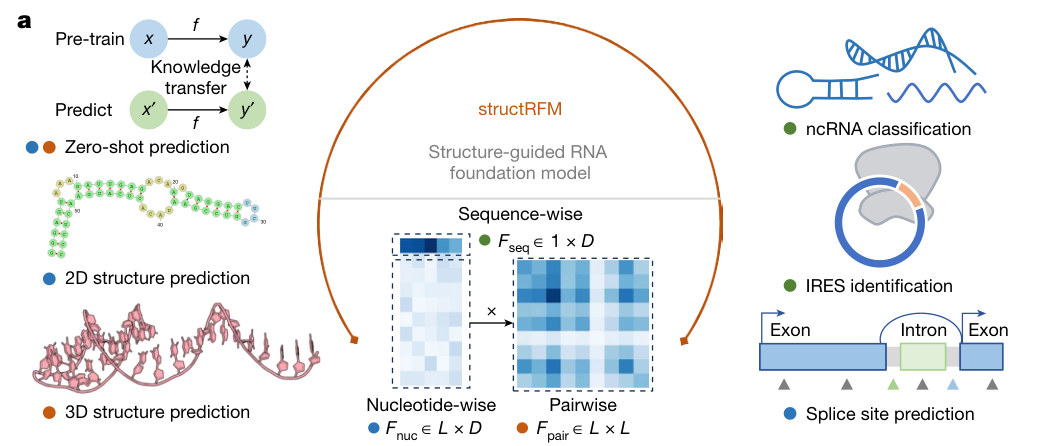
先给 RNA 的“字母串”配上折叠线索
RNA 可以想象成一条写着 A、U、G、C 的细带。细带折回时,部分位置会通过碱基配对连接,形成茎和环。序列记录字母顺序,二级结构记录哪些位置彼此配对。这些关系进一步参与塑造 RNA 的空间构象与功能。
RNA-FM、RiNALMo 等模型已通过大规模序列学习支持多种任务,结构增强模型也在持续发展。structRFM 选择从预训练的“遮字方式”切入。团队先从 RNAcentral v24.0 筛选出 21,477,078 条长度不超过 512 个核苷酸的 RNA。

接下来,需要给这些序列补充结构线索。团队提出 MUSES,将 ViennaRNA RNAfold、CONTRAfold 和 BPfold 的输出加权整合。三种方法分别带来热力学、统计学习,以及结合物理先验的深度学习视角。
这些二级结构标注来自计算预测,整合权重依次为 4∶1∶7。构建的数据集再划分为 20,403,223 组训练样本和 1,073,855 组测试样本。序列与结构由此组成配对资源,供基础模型开展预训练。

遮住一对碱基,让模型一起补回来
普通的掩码语言建模类似完形填空:随机遮住部分字母,再要求模型补齐。structRFM 加入 PairMatch 操作,把被选中位置的配对碱基也纳入掩码。模型需要结合周围序列与未遮住的环区线索,恢复成对位置的碱基。
这套方法称为结构引导掩码语言建模,即 SGMLM。训练中,结构引导掩码在混合策略中的比例从 0 逐步增至 0.5,再保持稳定。模型沿用恢复碱基的学习目标,通过掩码策略引入结构先验。

完成预训练后,模型读取 RNA 序列,可以输出整条序列的概括、每个核苷酸的表示,以及位置之间的关系矩阵。三种输出分别服务于序列分类、位点识别和结构预测。基础编码器采用 12 层 Transformer,隐藏维度为 768。
团队还检验了无需任务专用标注训练的同源分类能力。在 17 个生物语言模型的比较中,structRFM 在两个数据集上均进入前四。同源与非同源分布的重叠比在 Rfam 上为 0.10,在 ArchiveII600 上为 0.45;该指标越低,区分越清楚。

从碱基配对,走向三维折叠
在二级结构预测中,团队将核苷酸表示接入 MXfold2 结构模块,并通过动态规划生成配对结构。评估使用 INF 指标,衡量预测配对与参考结构的一致程度,数值越高越好。两个测试集分别包含 3,911 条和 1,305 条 RNA。
在 ArchiveII600 和 bpRNA-TS0 上,structRFM 的 INF 分别达到 0.890 和 0.669,RiNALMo-Mega 的对应结果为 0.858 和 0.638。相较于不含结构引导预训练的消融版本,论文报告的相对提升分别为 4.46% 和 6.19%。

三维结构适配版本名为 Zfold。团队把 structRFM 的成对特征接入 trRosettaRNA 框架,并结合多序列比对进行建模。该版本使用 3,633 条 PDB RNA 链进行微调,训练数据截止时间为 2022 年 1 月。
在 CASP15-natural、CASP16 和 RNA-Puzzles 上,Zfold 的平均 TM-score 分别为 0.45、0.33 和 0.58;消融版本为 0.30、0.22 和 0.34。结构引导预训练带来的收益,从二级结构预测延伸到了三维结构适配。

与论文采用的 AlphaFold 3 结果对照,Zfold 在 CASP15-natural 和 RNA-Puzzles 上的平均 TM-score 为 0.45、0.58,对照为 0.36、0.47。在 CASP16 上,两者分别为 0.33、0.42。三个集合对应 8、20、13 个 RNA 靶标。
论文同时展示了具体靶标的预测结构。以 RNA-Puzzles 的 PZ15 为例,Zfold 的 TM-score 为 0.73,消融版本为 0.35,RiNALMo-Mega 为 0.52。配图将各模型输出与浅粉色实验参考结构叠合,呈现局部与整体折叠的对应关系。

同一套表示,连接结构与功能任务
研究进一步考察了 IRES 识别。这类 RNA 元件可介导非帽依赖的翻译起始。在论文的 1,164 条平衡测试序列上,structRFM 的 F1 为 0.701,IRESfinder 和 DeepIRES 分别为 0.475 和 0.284。
在包含 13 类非编码 RNA 的 nRC 分类任务中,structRFM 的 F1 达到 0.979,RNAErnie 和 ncRDense 分别为 0.964 和 0.951。团队通过任务专用分类头和微调,将预训练表示用于这些序列级预测。

剪接位点预测则要求逐个位置识别供体、受体和非位点。按论文采用的 BEACON 配置微调后,structRFM 的平均 top-k 准确率为 0.416。论文正文按两位小数报告 RNA-MSM 为 0.38、RNA-FM 为 0.35,专用模型 SpliceBERT 为 0.45。
这项任务的输入是前体 mRNA,与预训练使用的非编码 RNA 存在类型差异。结构引导预训练得到的表示,经过微调可以迁移到不同 RNA 类型的预测任务。此处报告的是计算基准表现,衡量分类与位点识别能力。

新家族与长 RNA,继续检验可迁移性
团队从 Rfam v15.0 新增家族中整理出 436 条序列,这些家族未出现在预训练数据中。在分别使用 RNAStrAlign 和 bpRNA-1m 微调的模型上,新家族二级结构预测的 INF 达到 0.648 和 0.698。
测试还延伸到人和小鼠的长非编码 RNA 分类,纳入的序列最长为 3,000 个核苷酸。采用重叠滑窗时,人类数据的 F1 为 0.959,小鼠数据为 0.9455。这项评估检验了模型处理更长序列时的分类表现。

滑窗可以理解为分段阅读一篇长文,再汇总各段信息。团队比较了截断、不重叠滑窗,以及相邻窗口重叠 50% 的方案。重叠滑窗以 512 个核苷酸为窗口,在窗口交界处保留更多上下文,取得三种方案中最好的分类结果。
这组长 RNA 结果对应分类任务,基础模型的预训练长度上限仍为 512 个核苷酸。论文将更长序列的直接建模、全局远距离相互作用,以及更丰富的结构信息,列为后续研究方向。

数据、权重与代码一同开放
团队在 Zenodo 提供序列—结构预训练数据,并通过官方 GitHub 仓库提供代码、预训练模型和下游模型入口。这项工作同时交付了训练资源、结构引导方法和可用于下游适配的模型。代码仓库标注为 MIT 许可。
论文入口为 Nature 原文,资源入口为 structRFM 官方仓库与 Zenodo 数据集。研究团队接下来的方向,是让更多结构关系进入预训练,并把序列与结构的联合学习扩展到更长的 RNA。